Một máy tính AI nhỏ gọn của Trung Quốc nhắm đến đối thủ đắt tiền
Sipeed đang nhắm mức giá khoảng 3.999 USD cho máy tính MaixStation có bộ nhớ 128 GB, sử dụng chip AX8860P của nhà sản xuất chip Trung Quốc Axera. Máy chỉ có kích thước 11 x 11 x 3 cm và được quảng bá là có thể chạy các mô hình AI lớn cục bộ với mức tiêu thụ điện điển hình 40 watt. Đối thủ mà sản phẩm hướng đến là DGX Spark của Nvidia, một hệ thống AI nhỏ gọn có giá khoảng 6.950 USD với bộ nhớ 128 GB.
Nội dung
- Một máy tính AI nhỏ gọn của Trung Quốc nhắm đến đối thủ đắt tiền
- Những gì Axera tích hợp trong AX8860P
- Vì sao 128 GB quan trọng hơn con số TOPS nổi bật
- Trang điểm chuẩn chính thức cho thấy bức tranh khiêm tốn hơn
- Vì sao cần so sánh thận trọng các tuyên bố tốc độ trước đây
- Một chiếc hộp nhỏ gọn với bộ lưu trữ tiêu chuẩn
- Nhiều chip hứa hẹn tăng dung lượng, nhưng khả năng mở rộng vẫn chỉ là tuyên bố
- Cam kết về phần mềm giữ vai trò then chốt trong sử dụng hằng ngày
- Giá bán và giao hàng hiện gắn với chiến dịch gọi vốn
- Điểm chính
Axera giới thiệu chip này tại một triển lãm công nghiệp ở Thượng Hải ngày 13 tháng 10 năm 2026, cùng thời điểm Sipeed trình làng MaixStation. Lời chào hàng ban đầu gây chú ý: xử lý prompt nhanh hơn 25% và tạo câu trả lời nhanh hơn 30% so với DGX Spark khi chạy mô hình Qwen có 27 tỷ tham số, với mức giá chỉ bằng khoảng một nửa.
Trang sản phẩm MaixStation của Sipeed hiện cung cấp thông tin chi tiết hơn. Trang này nêu tốc độ xử lý prompt từ 592 đến 677 token mỗi giây trên Qwen3.8-27B và tốc độ tạo câu trả lời từ 6 đến 7 token mỗi giây. Các con số này thấp hơn những mức được đưa ra quanh thời điểm công bố, trong khi kế hoạch ra mắt chính thức dự kiến chiến dịch Kickstarter vào cuối năm 2026.
Sức hấp dẫn của sản phẩm khá rõ ràng: bộ nhớ lớn trong một máy tính nhỏ gọn có thể giúp nhà phát triển, văn phòng và người dùng cá nhân chạy các mô hình mạnh mà không phải thuê dịch vụ điện toán đám mây hoặc mua nhiều card đồ họa. Tuy nhiên, quyết định mua còn phụ thuộc vào phần mềm cuối cùng, hiệu năng đo được và lịch giao hàng, chứ không chỉ thông số chip.
Những gì Axera tích hợp trong AX8860P
Dòng AX8860 sử dụng quy trình sản xuất 6 nanomet, kết hợp 16 lõi CPU Arm Cortex-A55 với một bộ xử lý mạng nơ-ron chuyên dụng, hay NPU. NPU là bộ xử lý được thiết kế để thực hiện các phép tính lặp lại mà mô hình AI sử dụng. Axera và Sipeed công bố hiệu năng tối đa 256 nghìn tỷ phép tính mỗi giây, thường được viết tắt là 256 TOPS, khi dùng FP4.
FP4 lưu trữ các giá trị số với độ chính xác 4 bit. Dùng ít bit hơn sẽ giảm dung lượng bộ nhớ cần cho mô hình và có thể tăng tốc tính toán, dù mô hình và phần mềm phải hỗ trợ định dạng đó. Con số Axera công bố áp dụng cho tính toán dày đặc, không phải phép tính giả định có thể bỏ qua một số giá trị bằng kỹ thuật gọi là độ thưa.
Chip hỗ trợ PCIe 5.0 và giao tiếp bộ nhớ có độ rộng 256 bit. Sipeed nêu thông số bộ nhớ LPDDR5X-8533, tối đa 128 GB mỗi mô-đun và băng thông 273 GB mỗi giây. Mô-đun Maix-V có kích thước 78 x 78 mm và sử dụng đầu nối LPCAMM2.
Các lõi Cortex-A55 đảm nhiệm hệ điều hành và những tác vụ hỗ trợ, còn NPU được thiết kế để xử lý phần lớn khối lượng công việc AI. DGX Spark của Nvidia có 20 lõi Arm, trong đó có các lõi Cortex-X925 mạnh hơn; các máy AMD Ryzen AI Halo cạnh tranh sử dụng CPU Zen 5. Vì vậy, người dùng dự định kết hợp suy luận AI với khối lượng đáng kể các tác vụ tính toán thông thường cần cân nhắc nhiều yếu tố hơn chỉ riêng bộ tăng tốc.
Vì sao 128 GB quan trọng hơn con số TOPS nổi bật
Mô hình ngôn ngữ cần bộ nhớ để lưu các trọng số dạng số, vốn mã hóa những gì mô hình học được trong quá trình huấn luyện, cùng dữ liệu làm việc được tạo ra khi mô hình trả lời yêu cầu. Bộ tăng tốc nhanh nhưng có quá ít bộ nhớ có thể buộc người dùng chia mô hình cho nhiều thiết bị hoặc chuyển mô hình qua bộ lưu trữ chậm hơn.
Cấu hình 128 GB dự kiến của MaixStation xếp sản phẩm vào cùng nhóm dung lượng bộ nhớ với DGX Spark cỡ lớn hơn. Cả hai đều công bố băng thông 273 GB mỗi giây. Dòng Ryzen AI Halo của AMD có cấu hình 128 GB với băng thông khoảng 256 GB mỗi giây và phiên bản đắt hơn có 192 GB với băng thông 273 GB mỗi giây.
Dung lượng quyết định lượng dữ liệu có thể lưu vừa trong bộ nhớ. Băng thông quyết định tốc độ dữ liệu được chuyển đến bộ xử lý. Trong quá trình tạo văn bản thông thường bằng mô hình ngôn ngữ dày đặc, mỗi token mới được tạo ra đòi hỏi đọc lượng lớn dữ liệu mô hình. Token là một đơn vị văn bản nhỏ, đôi khi là một từ, đôi khi chỉ là một phần của từ.
Do đó, Sipeed lập luận rằng việc tận dụng bộ nhớ hiệu quả có thể giúp bộ xử lý 256 TOPS của hãng cạnh tranh với con số hiệu năng tính toán được quảng bá lớn hơn của Nvidia. Mức khoảng 1.000 TOPS FP4 của DGX Spark sử dụng kỹ thuật độ thưa; con số FP4 tính toán dày đặc của máy vào khoảng 500 nghìn tỷ phép tính mỗi giây. Tốc độ thực tế khi chạy ứng dụng còn phụ thuộc vào mức độ hiệu quả của phần mềm trong việc khai thác phần cứng.
Trang điểm chuẩn chính thức cho thấy bức tranh khiêm tốn hơn
Sipeed chia các bài kiểm tra thành prefill, giai đoạn mô hình xử lý prompt của người dùng, và decode, giai đoạn mô hình tạo câu trả lời. Prefill nhanh hơn có thể rút ngắn thời gian chờ trước khi câu trả lời bắt đầu, đặc biệt với tài liệu dài. Decode nhanh hơn giúp câu trả lời xuất hiện nhanh hơn sau khi quá trình tạo bắt đầu.
Với Qwen3.8-27B ở định dạng FP4 dày đặc, trang chính thức nêu tốc độ prefill của MaixStation là 592 đến 677 token mỗi giây, so với 550 của DGX Spark. Như vậy, mức dẫn trước vào khoảng 8% đến 23%. Tốc độ decode được liệt kê cho MaixStation là 6 đến 7 token mỗi giây, nhưng phần nội dung biểu đồ chính thức được cung cấp không nêu mốc decode bằng số của DGX Spark cho mô hình này.
Với Qwen3.6-35B-A3B, một mô hình hỗn hợp chuyên gia, Sipeed nêu tốc độ prefill từ 2.664 đến 3.256 token mỗi giây, so với 2.368 của DGX Spark. Mức dẫn trước tính toán được vào khoảng 13% đến 38%. Tốc độ decode là 34 đến 37 token mỗi giây, so với 34, tương đương từ ngang bằng đến dẫn trước khoảng 9%.
Mô hình hỗn hợp chuyên gia chỉ kích hoạt một phần mạng cho mỗi token. Điều này giúp lý giải vì sao tốc độ tạo văn bản của chúng có thể cao hơn nhiều so với mô hình dày đặc có tổng số tham số tương tự. Hai loại mô hình đòi hỏi lượng tính toán khác nhau cho mỗi token.
Sipeed mô tả các kết quả được hiển thị là những phép đo hiện tại theo hướng thận trọng và cho biết AX8860P vẫn đang được tinh chỉnh. Biểu đồ ghi rõ sử dụng FP4, tắt dự đoán nhiều token, hay MTP. MTP là kỹ thuật đề xuất đồng thời một số token tiếp theo để tăng tốc quá trình tạo.
Vì sao cần so sánh thận trọng các tuyên bố tốc độ trước đây
Các khoảng hiệu năng Sipeed từng công bố cao hơn: tốc độ prefill từ 1.400 đến 1.600 token mỗi giây và decode từ 15 đến 17 trên Qwen3.8-27B, so với các mốc của DGX Spark lần lượt là 1.300 và 13. Với mô hình hỗn hợp chuyên gia, các khoảng này là 6.300 đến 7.700 cho prefill và 80 đến 88 cho decode, so với 5.600 và 80. Sau đó, Sipeed cũng đưa ra một phép so sánh cho thấy MaixStation nhanh hơn khoảng 10% ở cả hai giai đoạn, đồng thời nói rằng các lần chạy mới hơn cho thấy mức dẫn trước lớn hơn không phải kết quả chính thức.
Các con số tuyệt đối thấp hơn trên trang chính thức khiến điều kiện kiểm tra càng cần được lưu ý. Độ dài prompt, số lượng yêu cầu xử lý đồng thời, định dạng số, phần mềm runtime và phiên bản trình điều khiển đều có thể làm thay đổi kết quả. Các lần chạy DGX Spark độc lập được dẫn trong bài viết đạt khoảng 11,5 đến 11,6 token mỗi giây trên Qwen3.8-27B khi không dùng giải mã suy đoán, trong khi tốc độ prefill dao động từ 840 đến 1.900 tùy phần mềm.
Một phép tính bộ nhớ đơn giản giúp lý giải vì sao tuyên bố trước đây về tốc độ 17 token mỗi giây được chú ý. Nếu mô hình đang chạy chiếm khoảng 16 GB, lấy 273 GB mỗi giây chia cho 16 GB sẽ ra khoảng 17 token mỗi giây, trước khi tính đến lưu lượng bộ nhớ khác. Để đạt tốc độ đó cần khai thác băng thông được quảng bá ở mức đặc biệt cao.
Dung lượng bộ nhớ thực tế của mô hình rất quan trọng ở đây. Bốn bit nhân với 27 tỷ tham số tương đương khoảng 13,5 GB chỉ riêng cho trọng số, trong khi dữ liệu tỷ lệ số và các phần lưu trữ khác có thể làm tăng dung lượng cần dùng. Những bài kiểm tra chi tiết, có thể lặp lại sẽ giúp người mua đối chiếu các con số tốc độ với một cấu hình mô hình cụ thể.
Một chiếc hộp nhỏ gọn với bộ lưu trữ tiêu chuẩn
Kích thước MaixStation được quảng bá tương đương thể tích 363 cm khối. Sipeed so sánh con số này với 1.125 cm khối của DGX Spark, nghĩa là vỏ máy dự kiến chỉ bằng khoảng một phần ba thể tích. Công ty cho biết máy có thể nhận điện qua USB-C từ pin dự phòng phù hợp, công suất định mức 65 watt.
Trang chính thức nêu mức tiêu thụ điện điển hình của MaixStation là 40 watt và của DGX Spark là 120 watt. Đây là các mức tải điển hình do Sipeed công bố. Thông tin ban đầu về AX8860 cũng nêu mức 40 watt cho mô-đun chuyên dụng, nên phạm vi đo điện năng sẽ là một chi tiết hữu ích cần kiểm chứng sau này.
Các cổng kết nối gồm mạng 10G SFP+, USB-C, đầu nối MCIO 8i và khe M.2 2280 tiêu chuẩn cho ổ SSD. Định dạng lưu trữ này giúp người mua dễ dàng mở rộng dung lượng cho tệp mô hình, vốn có thể nhanh chóng chiếm hàng trăm gigabyte.
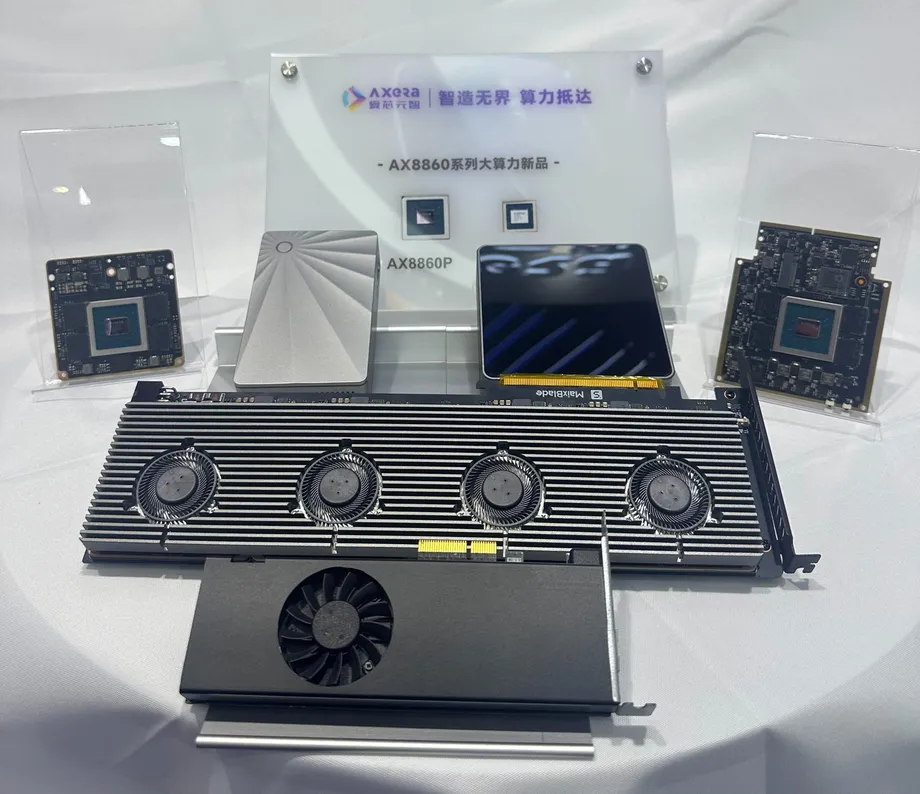
Kế hoạch phần cứng của Axera không chỉ giới hạn ở máy tính để bàn nhỏ gọn. Các thiết kế gồm một mô-đun, một card PCIe dùng một chip và một card dùng bốn chip, bốn quạt cùng đầu nối nguồn tiêu chuẩn tám chân. Sipeed gắn MaixStation Pro và MaixBlade với các cấu hình có dung lượng 512 GB trở lên.
Nhiều chip hứa hẹn tăng dung lượng, nhưng khả năng mở rộng vẫn chỉ là tuyên bố
Sipeed cho biết MaixStation có thể kết nối tối đa tám nút mà không cần bộ chuyển mạch ngoài, thông qua kết nối giữa các chip có tốc độ 256 gigabit mỗi giây và có thể mở rộng lên 384 gigabit mỗi giây. DGX Spark dùng kết nối 200 gigabit để liên kết các hệ thống, còn cấu hình bốn máy Spark cần một bộ chuyển mạch ngoài.
Cần phân biệt gigabit với gigabyte. Kết nối có tốc độ 256 gigabit mỗi giây tương đương tốc độ thô 32 gigabyte mỗi giây trước khi tính phần hao hụt. Băng thông bộ nhớ 273 gigabyte mỗi giây mô tả một kết nối khác, nhanh hơn nhiều, bên trong mỗi máy.
Axera công bố hai chip đạt tổng cộng 512 TOPS và bốn chip đạt 1.024 TOPS, đồng thời tuyên bố hiệu suất mở rộng khoảng 80%. Con số mở rộng với bốn chip đến từ mô phỏng trong phòng thí nghiệm. Việc chia mô hình giữa nhiều bộ xử lý cũng tạo thêm công việc truyền thông và đồng bộ hóa, nên tốc độ ứng dụng không chỉ phụ thuộc vào việc cộng các mức hiệu năng tính toán đỉnh của từng chip.
Lộ trình của Axera nêu AX8950 đạt tối đa 500 TOPS và AX8970 vượt 700 TOPS. Những bộ xử lý dự kiến này sẽ tạo điều kiện nâng cấp trong tương lai, nhưng đề xuất trước mắt của MaixStation dựa trên AX8860P và phần mềm đi kèm.
Cam kết về phần mềm giữ vai trò then chốt trong sử dụng hằng ngày
Sipeed liệt kê Debian 13 với Linux 6.18, cùng khả năng hỗ trợ vLLM, SGLang, PyTorch, llama.cpp và Ollama. Các công cụ này giúp tải mô hình, xử lý yêu cầu và kết nối ứng dụng AI với phần cứng. Công ty cũng quảng bá các API tương thích với OpenAI và Anthropic, cho phép ứng dụng hiện có gửi yêu cầu đến thiết bị cục bộ.
Phần hỏi đáp sản phẩm của Sipeed giải thích rằng các tên framework quen thuộc này hoạt động trên lớp phần mềm được viết riêng cho phần cứng Axera:
SGLang và vLLM chạy thông qua một backend tăng tốc phần cứng tùy chỉnh, với các kernel được viết bằng AXDSL.
Kernel là những đoạn phần mềm nhỏ thực hiện các phép tính cốt lõi trên bộ tăng tốc. Sipeed cho biết người dùng có thể tải trực tiếp các mô hình Hugging Face được hỗ trợ, trong khi kiến trúc mô hình mới có thể cần các kernel viết bằng AXDSL. Công ty hứa sẽ công bố kernel và công cụ phát triển, đồng thời cho biết đang tiến hành mở bộ công cụ phát triển phần mềm AX8860.
Công ty quảng bá rằng các mô hình và giao diện trình duyệt sẽ sẵn sàng ngay khi khởi động. Các mục đích sử dụng được đề xuất gồm tác nhân lập trình, xử lý tài liệu, tạo video và robot học. Card PCIe trước tiên hỗ trợ máy chủ Linux; hỗ trợ Windows sẽ tùy thuộc nhu cầu. Tại thời điểm công bố, bộ công cụ NPU dự kiến sẽ sẵn sàng vào cuối tháng 10.
Giá bán và giao hàng hiện gắn với chiến dịch gọi vốn
Mức giá dự kiến 3.999 USD của Sipeed cho phiên bản 128 GB thấp hơn khoảng 2.951 USD, tương đương 42%, so với DGX Spark giá 6.950 USD. Đây là mức giảm đáng kể, dù chưa đến một nửa. Giá này cũng sẽ đưa MaixStation ngang tầm với AMD Ryzen AI Halo 128 GB, có giá khoảng 3.999,99 USD.
Lịch triển khai đã thay đổi so với dự kiến ban đầu là các thiết bị sẽ ra mắt trong năm 2026. Sipeed đã mở đăng ký giữ chỗ, nhưng phần hỏi đáp chính thức cho biết chiến dịch Kickstarter sẽ diễn ra vào cuối năm 2026. Sipeed cho biết dự kiến giao hàng trong vòng ba tháng sau khi chiến dịch kết thúc.
- Ngày 13 tháng 10 năm 2026: Axera giới thiệu dòng AX8860 tại Thượng Hải và Sipeed trình làng MaixStation.
- Cuối tháng 10 năm 2026: Sipeed dự kiến bộ công cụ NPU sẽ được cung cấp.
- Cuối năm 2026: Sipeed lên kế hoạch tổ chức chiến dịch Kickstarter cho MaixStation.
- Trong vòng ba tháng sau khi chiến dịch kết thúc: Mục tiêu giao hàng do Sipeed công bố.
Sipeed chưa xác nhận giá bán lẻ cuối cùng, ngày giao hàng cụ thể hay hiệu năng MaixStation đã được xác minh độc lập. Năng lực sản xuất, phương án hỗ trợ, cùng giá và thời điểm ra mắt phiên bản Pro 512 GB cũng chưa được chốt. Công ty dự kiến cung cấp quyền truy cập từ xa và các máy đánh giá trong thời gian diễn ra chiến dịch, tạo cơ hội tiếp theo để người mua tiềm năng kiểm tra các tuyên bố.
Điểm chính
- MaixStation nhắm mức giá khoảng 3.999 USD cho bộ nhớ 128 GB và bộ xử lý Axera AX8860P có hiệu năng 256 TOPS ở FP4 dày đặc.
- Sipeed công bố băng thông bộ nhớ 273 GB mỗi giây, mức tiêu thụ điện điển hình 40 watt và vỏ máy có kích thước 11 x 11 x 3 cm.
- Trang điểm chuẩn chính thức cho thấy tốc độ tuyệt đối thấp hơn các mức từng công bố, với kết quả thay đổi tùy mô hình và giai đoạn xử lý.
- Phần mềm hỗ trợ dựa trên backend tăng tốc tùy chỉnh của Axera; công ty hứa sẽ công khai công cụ phát triển và thêm mã nguồn.
- Chiến dịch Kickstarter dự kiến diễn ra vào cuối năm 2026, sau đó Sipeed đặt mục tiêu giao hàng trong vòng ba tháng kể từ khi chiến dịch kết thúc.
- Kiểm tra độc lập, giá cuối cùng và cam kết giao hàng sẽ quyết định hệ thống dự kiến này cạnh tranh ra sao với các lựa chọn của Nvidia và AMD.