Một triệu lượt trao đổi biến những từ tự tạo thành ý nghĩa chung
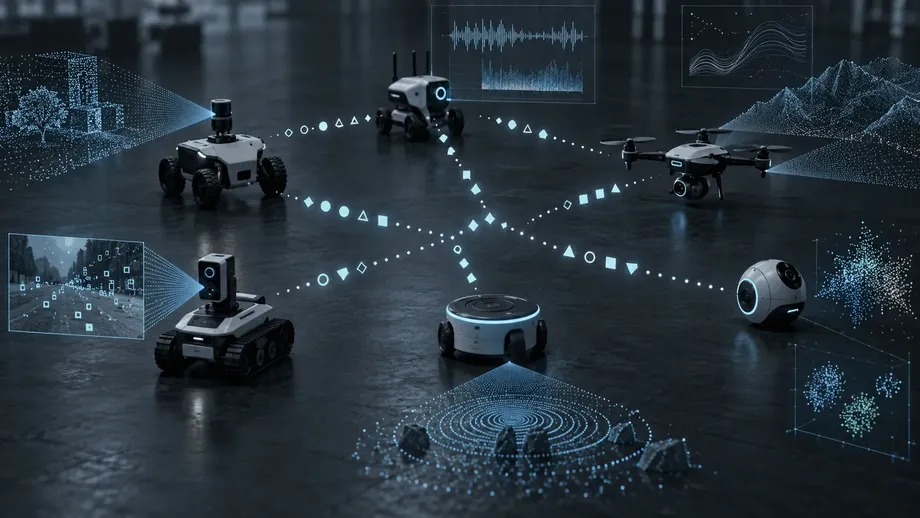
Mười tác nhân trí tuệ nhân tạo, khởi đầu với vốn từ trống, đã học cách nhận diện vật thể cho nhau với tỷ lệ thành công lên đến 99.76% sau một triệu lượt tương tác, trong các thí nghiệm của các nhà nghiên cứu tại Vrije Universiteit Brussel (VUB) và Đại học Namur ở Bỉ. Từ ngữ và ý nghĩa của chúng hình thành qua những lượt trao đổi lặp đi lặp lại, thay vì dựa trên từ điển do con người biên soạn.
Nội dung
- Một triệu lượt trao đổi biến những từ tự tạo thành ý nghĩa chung
- Cách một từ trở nên hữu ích
- Các tác nhân lưu trữ ý nghĩa như thế nào
- Vốn từ chung hoạt động hiệu quả đến đâu?
- Các cảm biến khác nhau vẫn có thể đạt được sự thống nhất
- Vốn từ thay đổi khi dữ liệu đầu vào biến mất
- Nhóm càng lớn càng cần nhiều lượt trao đổi
- Con người có thể kiểm tra từ ngữ ám chỉ điều gì
- Công bố, hợp tác và ứng dụng tiềm năng
- Điểm chính
Các nhà nghiên cứu thử nghiệm phương pháp trên 37 bộ dữ liệu công khai, từ các phép đo hóa học của rượu vang và dữ liệu ngoại hành tinh của NASA đến ảnh chim và khuôn mặt người. Trong bảy bộ dữ liệu được nêu bật, tỷ lệ thành công ở các lượt tương tác kiểm thử dao động từ 95.77% đến 99.76%.
Thành tựu cốt lõi là đạt được sự thống nhất về cách gọi tên sự vật. Mỗi tác nhân duy trì những mối liên hệ riêng giữa các từ tự tạo và những đặc tính quan sát được. Qua phản hồi, các mối liên hệ riêng lẻ trở nên tương thích đủ để cả nhóm giao tiếp, ngay cả khi các thành viên cảm nhận môi trường khác nhau.
Bài nghiên cứu có tiêu đề Emergent Communication in Continuous Worlds: Self-Organisation of Conceptually Grounded Vocabularies at Scale, mô tả các thí nghiệm trong môi trường mô phỏng máy tính. Các tác nhân làm việc với những biểu diễn số của vật thể và hình ảnh. Theo các nhà nghiên cứu, robot, xe tự hành và cảm biến công nghiệp là những ứng dụng tiềm năng của phương pháp này.
Cách một từ trở nên hữu ích
Mỗi lượt trao đổi có hai tác nhân tham gia. Một tác nhân đóng vai người nói, tác nhân kia làm người nghe; vai trò được phân công lại khi các tương tác tiếp tục. Cả hai cùng gặp một khung cảnh có nhiều đối tượng, nhưng chỉ người nói được cho biết đối tượng nào là mục tiêu.
Người nói phải chọn một từ giúp người nghe xác định mục tiêu đó. Nếu vốn từ chưa có từ phù hợp, tác nhân sẽ tự tạo một từ. Bài nghiên cứu sử dụng các chuỗi âm tiết tùy ý gồm ba âm tiết, chẳng hạn "demoxu", nên bản thân nhãn từ không mang ý nghĩa có sẵn.
Người nghe đối chiếu từ đó với các khái niệm đã lưu và chọn một đối tượng. Cả hai tác nhân đều nhận được phản hồi về việc lựa chọn có chính xác hay không. Sau khi chọn sai, người nghe được tiết lộ mục tiêu, nhờ đó có thêm thông tin để điều chỉnh cách hiểu.
Các nhà nghiên cứu cung cấp quy trình tạo từ, biểu diễn khái niệm và học từ kết quả. Vốn từ cụ thể cùng các phạm trù gắn với nó hình thành trong quá trình tương tác. Những lượt trao đổi thành công củng cố các mối liên hệ hữu ích, trong khi trải nghiệm tiếp theo điều chỉnh các khái niệm gắn với từ ngữ.
Katrien Beuls, giáo sư tại Đại học Namur và đồng tác giả, mô tả cách các trao đổi cục bộ tạo ra sự thống nhất trong cả cộng đồng trong thông cáo của trường đại học:
Điều thú vị là không có máy tính trung tâm nào áp đặt các quy tắc. Mỗi lần, chúng tôi để hai tác nhân giao tiếp với nhau ở cấp độ cục bộ. Chính thông qua những tương tác và cập nhật riêng lẻ này mà một quy ước chung tự phát hình thành trong toàn bộ cộng đồng.
Các tác nhân lưu trữ ý nghĩa như thế nào
Mỗi đối tượng được đưa đến tác nhân dưới dạng một vectơ đặc trưng, tức danh sách các giá trị mô tả thuộc tính của đối tượng. Chẳng hạn, mẫu rượu vang có thể được biểu diễn bằng các phép đo hóa học. Hình ảnh có thể được biểu diễn bằng các đặc trưng số do hệ thống thị giác trích xuất.
Mỗi từ được liên kết với một nguyên mẫu khái niệm: mô tả toán học về những loại quan sát mà từ đó áp dụng. Nguyên mẫu ghi lại các giá trị điển hình, mức độ biến thiên của chúng và những đặc trưng quan trọng nhất. Nhờ vậy, tác nhân có thể đánh giá một đối tượng mới gặp phù hợp với từ quen thuộc đến mức nào.
Ngữ cảnh cũng đóng vai trò quan trọng. Người nói tìm một từ có khái niệm phù hợp với mục tiêu hơn các đối tượng khác trong khung cảnh. Vì thế, một từ hữu ích giúp phân biệt một đối tượng với những lựa chọn thay thế ngay trước mắt, thay vì chỉ gắn nhãn cố định cho mọi vật.
Các tác nhân lưu giữ riêng những biểu diễn này. Chúng không thể truy cập thiết lập nội bộ của nhau hay một cơ sở tri thức trung tâm. Giao tiếp chung phát triển vì từ ngữ giúp chúng đưa ra những lựa chọn tương thích, trong khi biểu diễn riêng của từng tác nhân vẫn gắn với các quan sát của chính nó.
Với các bộ dữ liệu hình ảnh, các nhà nghiên cứu sử dụng đặc trưng 384 chiều từ DINOv2, một bộ mã hóa thị giác hiện có. Bộ mã hóa thị giác chuyển hình ảnh thành mô tả số để phần mềm khác xử lý. Sau đó, quá trình học từ vựng diễn ra trên những mô tả này.
Vốn từ chung hoạt động hiệu quả đến đâu?
Trong các thí nghiệm tiêu chuẩn, các nhà nghiên cứu huấn luyện nhóm 10 tác nhân qua một triệu lượt tương tác. Sau đó, họ đánh giá khả năng giao tiếp qua 100,000 lượt tương tác kiểm thử, bao gồm cả những đối tượng không có trong dữ liệu huấn luyện, rồi lấy kết quả trung bình của 10 lần chạy độc lập.
Bảy kết quả được nêu bật cho thấy cả hiệu quả của phương pháp lẫn mức chênh lệch giữa các nhiệm vụ:
- CLEVR, bộ dữ liệu về thuộc tính thị giác của vật thể: tỷ lệ giao tiếp thành công 99.76%.
- Dữ liệu phân tích rượu vang: 99.76%.
- Dữ liệu ngoại hành tinh: 99.67%.
- Dữ liệu nấm: 98.10%.
- Dữ liệu hình ảnh MS COCO: 95.77%.
- Ảnh khuôn mặt CelebA: 96.66%.
- Ảnh chim: 95.88%.
Các tỷ lệ này đo mức độ thường xuyên người nghe chọn đúng đối tượng mục tiêu. Với các nhiệm vụ về rượu vang và CLEVR, tỷ lệ 99.76% tương ứng với khoảng 24 lượt trao đổi không thành công trên mỗi 10,000 lượt kiểm thử. Với MS COCO, tỷ lệ 95.77% tương ứng với khoảng 423 lượt trên mỗi 10,000.
Chênh lệch giữa hai kết quả đó là 3.99 điểm phần trăm. Khả năng giao tiếp vẫn đạt mức thành công cao trong các nhiệm vụ được nêu bật, nhưng các bộ dữ liệu ảnh tự nhiên tạo ra nhiều lỗi hơn các nhiệm vụ về rượu vang và ngoại hành tinh.
Nhóm nghiên cứu cũng đo quy mô vốn từ và mức độ thống nhất về quy ước, tức mức độ nhất quán trong cách các tác nhân sử dụng từ ngữ. Những thước đo này phản ánh các khía cạnh khác nhau của quá trình: cả nhóm cần có một tập hợp nhãn khả dụng và đủ thống nhất về cách sử dụng chúng để nhận diện mục tiêu một cách đáng tin cậy.
Các cảm biến khác nhau vẫn có thể đạt được sự thống nhất
Máy móc hiếm khi quan sát thế giới theo cùng một cách. Cảm biến có thể được hiệu chuẩn khác nhau, số liệu có thể nhiễu và một thiết bị có thể thu nhận những đặc tính mà thiết bị khác không phát hiện được. Nghiên cứu đã kiểm tra các biến thể của những điều kiện này.
Paul Van Eecke, giáo sư trí tuệ nhân tạo tại VUB và đồng tác giả, giải thích động cơ nghiên cứu qua ví dụ con người nhận diện một chiếc ô tô màu đỏ. Mọi người có thể hiểu cùng một mô tả dù mắt họ ghi nhận các giá trị màu hơi khác nhau. Từ ngữ chung vượt lên trên những khác biệt trong cảm nhận riêng này.
Các thí nghiệm áp dụng ý tưởng đó cho tác nhân nhân tạo bằng cách thay đổi những gì chúng quan sát được. Nhóm nghiên cứu đưa vào các độ lệch số mô phỏng khác biệt hiệu chuẩn, nhiễu trong giá trị quan sát và các nhóm có thành viên sở hữu những tập đặc trưng sẵn có khác nhau.
Trong các thí nghiệm CLEVR có nhiễu mạnh, tỷ lệ giao tiếp thành công đạt 87.67%. Ở điều kiện có khác biệt lớn hơn về các cảm biến sẵn có, tỷ lệ này là 83.47%. Phương pháp vẫn giúp phối hợp đáng kể trong những điều kiện đó, dù độ chính xác thấp hơn so với thí nghiệm CLEVR tiêu chuẩn.
Bài nghiên cứu mô tả các nhóm có cấu trúc cảm nhận khác nhau là dị hình. Nói đơn giản, các thành viên nhận được những loại hoặc lượng thông tin khác nhau. Nhiệm vụ của họ là phát triển cách gọi tên tương thích bất chấp những khác biệt đó, dựa trên các quan sát mà từng thành viên có thể tiếp cận.
Vốn từ thay đổi khi dữ liệu đầu vào biến mất
Các nhà nghiên cứu cũng thử nghiệm tình huống thông tin đột ngột bị mất trong quá trình học. Trong một thí nghiệm, một nửa số đầu vào đại diện cho dữ liệu cảm biến bị loại bỏ giữa chừng. Sau thay đổi đó, tỷ lệ giao tiếp thành công đạt 93.82%.
Tương tác tiếp diễn tạo cơ hội để các tác nhân điều chỉnh khái niệm khi điều kiện thay đổi. Một từ gắn với nhiều đặc trưng có thể trở nên hữu ích theo cách khác khi một số đặc trưng biến mất và các quan sát còn lại trở nên quan trọng hơn.
Bài nghiên cứu cũng ghi nhận khả năng thích ứng với những thay đổi của môi trường. Điều này khiến việc học liên tục trở thành phần cốt yếu của phương pháp: nhóm xây dựng quy ước thông qua sử dụng và tiếp tục điều chỉnh quy ước đó khi các quan sát thay đổi.
Đối với một hệ thống máy móc trong tương lai, năng lực này có thể hữu ích khi thiết bị xuống cấp hoặc điều kiện vận hành thay đổi. Kết quả thực nghiệm hiện tại cho thấy các tác nhân có thể điều chỉnh vốn từ trong những nhiệm vụ mô phỏng.
Nhóm càng lớn càng cần nhiều lượt trao đổi
Nghiên cứu xem xét các nhóm gồm 2, 10, 25, 50 và 100 tác nhân. Việc mở rộng quy mô nhóm làm thay đổi mức độ phổ biến cần thiết của mỗi từ hữu ích, bởi các lượt trao đổi vẫn diễn ra giữa từng cặp cá nhân.
Trong các thí nghiệm CLEVR với 100 tác nhân, tỷ lệ giao tiếp thành công đạt 92.69% sau một triệu lượt tương tác. Kéo dài huấn luyện lên 10 triệu lượt tương tác giúp tỷ lệ này tăng lên 99.16%, tức tăng 6.47 điểm phần trăm.
Ngân sách tương tác giúp lý giải quy mô thách thức đó. Nếu mức độ tham gia được phân bổ đồng đều, một triệu lượt trao đổi, mỗi lượt có hai tác nhân, tương đương trung bình 200,000 lượt tham gia cho mỗi tác nhân trong nhóm 10 người. Với nhóm 100 người, cùng số lượt trao đổi chỉ tương đương trung bình 20,000 lượt tham gia cho mỗi tác nhân.
Mười triệu lượt trao đổi đưa mức trung bình trở lại 200,000 lượt tham gia cho mỗi thành viên trong nhóm 100 tác nhân. Các cặp gặp gỡ được chọn ngẫu nhiên, nhưng so sánh này cho thấy vì sao một nhóm lớn hơn có thể cần ngân sách học tập tổng thể lớn hơn nhiều để phổ biến các quy ước.
Con người có thể kiểm tra từ ngữ ám chỉ điều gì
Các nhà nghiên cứu xem tính dễ diễn giải là một ưu điểm trong thiết kế của họ. Mỗi từ trỏ đến một nguyên mẫu có các giá trị và trọng số đặc trưng có thể kiểm tra. Các nhà nghiên cứu có thể lần theo những quan sát góp phần hình thành khái niệm và cách biểu diễn của khái niệm đó thay đổi qua quá trình sử dụng.
Với bộ dữ liệu có các phép đo hóa học được đặt tên, việc kiểm tra có thể liên hệ một từ với những khoảng giá trị cụ thể của các phép đo đó. Với dữ liệu hình ảnh, khái niệm gắn với các đặc trưng do bộ mã hóa thị giác tạo ra, nên giải thích ý nghĩa của khái niệm cũng đòi hỏi phải hiểu những biểu diễn số của hình ảnh này.
Jérôme Botoko Ekila, nghiên cứu sinh tiến sĩ tại Phòng thí nghiệm Trí tuệ nhân tạo của VUB và đồng tác giả, mô tả mục đích của việc để các tác nhân xây dựng khái niệm dựa trên nhận thức riêng:
Chúng xây dựng các khái niệm hữu ích, tương ứng chính xác với những gì chúng cảm nhận qua cảm biến, ngay cả khi con người không thể hiểu được dữ liệu.
Việc giám sát của con người sẽ bao gồm kiểm tra các mối liên hệ đó khi chúng hình thành. Một phép kiểm tra hữu ích là xem hai tác nhân dùng cùng một từ có tiếp tục chọn đúng đối tượng mục tiêu sau khi đầu vào hoặc môi trường thay đổi hay không. Cơ chế phản hồi trong nghiên cứu đặt mối quan hệ này vào vị trí trọng tâm của quá trình học.
Công bố, hợp tác và ứng dụng tiềm năng
Công trình quy tụ Jérôme Botoko Ekila, Lara Verheyen, Jens Nevens và Paul Van Eecke tại VUB, cùng Katrien Beuls tại Đại học Namur. Nghiên cứu nhận tài trợ từ Quỹ Nghiên cứu Flanders (FWO) và Quỹ Nghiên cứu Quốc gia Bỉ (FNRS) thông qua dự án WEAVE.
Hồ sơ công bố của VUB cho biết bài báo đăng trên tạp chí Transactions of the Association for Computational Linguistics, tập 14, trang 2234–2257, DOI 10.1162/TACL.a.799. Hồ sơ ghi thời điểm công bố là tháng 8 năm 2026.
Quá trình công bố và thông báo diễn ra theo trình tự sau:
- Tháng 4 năm 2026: Bài báo được gửi.
- Tháng 5 năm 2026: Bài báo được sửa đổi.
- Tháng 8 năm 2026: Hồ sơ công bố của trường đại học ghi nhận bài báo được đăng trên tạp chí.
- Ngày 14 tháng 10 năm 2026: Trường đại học công bố các phát hiện.
Các nhà nghiên cứu nêu xe tự hành, robot và cảm biến công nghiệp là những đối tượng có thể ứng dụng phương thức giao tiếp thích ứng với cảm nhận của máy móc. Lidar đo khoảng cách bằng ánh sáng, sonar sử dụng âm thanh, cảm biến hồng ngoại phát hiện bức xạ liên quan đến nhiệt độ, còn thiết bị hóa học đo các chất. Vốn từ chung có thể giúp máy móc tham chiếu những dạng thức hữu ích trong các loại dữ liệu đầu vào như vậy.
Bước thực tiễn tiếp theo là kiểm tra cách các quy ước này hoạt động với thiết bị vật lý, môi trường thay đổi và yêu cầu vận hành. Chưa có thời hạn triển khai nào được công bố. Hiện tại, kết quả là một phương pháp đã được kiểm chứng để xây dựng các cách tham chiếu chung giữa nhiều loại dữ liệu, với hiệu suất có thể đo lường trong điều kiện nhiễu, khác biệt về cảm nhận và mất dữ liệu đầu vào.
Điểm chính
- Các nhà nghiên cứu tại VUB và Đại học Namur thử nghiệm quá trình hình thành vốn từ trên 37 bộ dữ liệu công khai.
- Các nhóm gồm 10 tác nhân được huấn luyện qua một triệu lượt tương tác, sau đó trải qua 100,000 lượt tương tác kiểm thử.
- Tỷ lệ thành công trong bảy bộ dữ liệu được nêu bật dao động từ 95.77% đến 99.76%.
- Các nhà nghiên cứu cung cấp quy trình học; thông qua phản hồi, các tác nhân tự phát triển từ ngữ cụ thể và những khái niệm liên quan.
- Các thí nghiệm kiểm tra khả năng thích ứng với quan sát nhiễu, cấu trúc cảm nhận khác nhau và dữ liệu đầu vào bị thiếu.
- Một nhóm 100 tác nhân đạt tỷ lệ thành công 99.16% trên CLEVR sau 10 triệu lượt tương tác.
- Nghiên cứu sử dụng mô phỏng máy tính. Robot, xe cộ và cảm biến công nghiệp là những ứng dụng được đề xuất.