Samsung đặt dung lượng bộ nhớ bên cạnh tốc độ xử lý
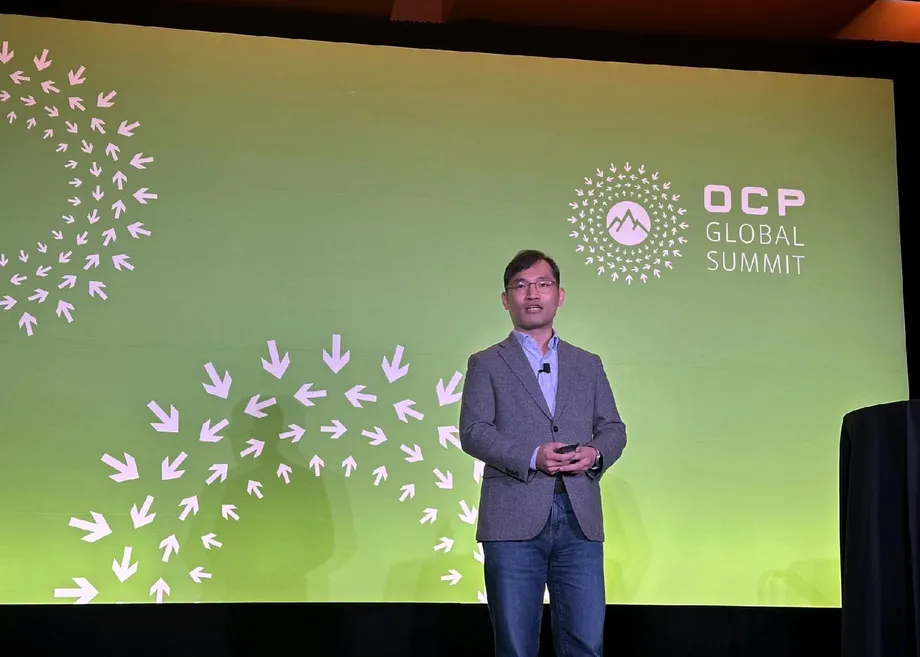
Samsung Electronics đang mở rộng chiến lược hạ tầng AI vượt ra ngoài bộ nhớ băng thông cao, kết hợp HBM5 và bộ nhớ tùy chỉnh với hợp tác cùng AMD về bộ nhớ máy chủ dùng chung, cũng như các công nghệ lưu trữ đưa một phần xử lý dữ liệu vào SSD. Công ty đã giới thiệu phương thức này tại OCP Global Summit 2026, dự kiến diễn ra từ ngày 12 đến 15 tháng 10 tại Trung tâm Hội nghị San Jose McEnery, California.
Nội dung
- Samsung đặt dung lượng bộ nhớ bên cạnh tốc độ xử lý
- HBM5 mở đầu chiến lược tăng tốc rộng hơn
- Hợp tác với AMD hướng đến dung lượng bộ nhớ linh hoạt
- Bộ nhớ đệm KV kết nối mở rộng bộ nhớ với lưu trữ
- SSD đảm nhiệm dung lượng, làm mát và sắp xếp dữ liệu
- Đưa phép tính đến gần dữ liệu được lưu trữ
- Thử nghiệm với khách hàng và sản phẩm đúc chip mở rộng phạm vi giới thiệu
- Quan hệ hợp tác được phát triển qua nhiều tháng
- Quy mô thị trường không quyết định mức độ sẵn sàng thương mại
- Điểm chính
Những tuyên bố cụ thể nhất về hiệu năng liên quan đến các công nghệ ở những tầng khác trong hệ thống bộ nhớ. Samsung cho biết việc phân bổ bộ nhớ CXL linh hoạt giúp giảm tới 38% thời gian trước khi mô hình AI tạo ra token đầu tiên; xử lý trong bộ nhớ bằng LPDDR5X giúp hiệu năng suy luận tăng tới ba lần; và tốc độ đọc tuần tự của SSD đạt 28,4 GB/s. Đây là kết quả từ những cuộc đánh giá hoặc trình diễn cụ thể, không phải mức bảo đảm cho mọi hệ thống AI.
Trang chính thức của hội nghị sắp xếp chiến lược của Samsung xoay quanh tốc độ, mở rộng bộ nhớ và lưu trữ bền vững. Các sản phẩm tiêu biểu gồm HBM4E, LPDDR5X-PIM, mô-đun bộ nhớ CMM-D MD310, bộ nhớ máy chủ SOCAMM2 và SSD PM1763, BM1773.
Samsung cho biết Hojun Shim, phó chủ tịch tập đoàn kiêm trưởng nhóm Kỹ thuật Ứng dụng thuộc Bộ phận Kinh doanh Bộ nhớ, dự kiến trình bày ba ưu tiên này trong phiên dành cho lãnh đạo ngày 12 tháng 10. Các bài tường thuật mô tả buổi trình bày là khởi đầu cho nỗ lực rộng hơn nhằm tối ưu đồng bộ bộ xử lý, bộ nhớ và lưu trữ, thay vì cải thiện từng thành phần riêng lẻ.
Sự khác biệt này có ý nghĩa trong quá trình suy luận, khi mô hình đã huấn luyện tạo câu trả lời. Bộ tăng tốc nhanh vẫn có thể phải chờ dữ liệu, thiếu bộ nhớ khi các cuộc hội thoại kéo dài hoặc gặp độ trễ khi truy xuất thông tin từ ổ lưu trữ. Samsung đề xuất các công nghệ khác nhau để xử lý từng hạn chế đó.
HBM5 mở đầu chiến lược tăng tốc rộng hơn
Các bài tường thuật về triển lãm nêu HBM5, được mô tả là thế hệ thứ tám của bộ nhớ băng thông cao, HBM tùy chỉnh và zHBM trong số những sáng kiến tăng tốc của Samsung. Bộ nhớ băng thông cao cung cấp lượng dữ liệu lớn cho bộ tăng tốc thông qua nhiều kết nối song song. Các phiên bản tùy chỉnh nhằm đáp ứng yêu cầu hệ thống của từng khách hàng.
Danh sách sản phẩm chính thức nêu HBM4E thay vì HBM5. Một số bài tường thuật khác cho biết triển lãm có mô hình ý tưởng HBM4E và HBM5. Điểm khác biệt này rất quan trọng: việc trưng bày hoặc giới thiệu ý tưởng không chứng minh sản phẩm đã được xuất xưởng; trang hội nghị của Samsung cũng không nêu ngày thương mại hóa HBM5 hay thông số hiệu năng chi tiết.
Bằng chứng định lượng rõ nhất về tốc độ xử lý đến từ LPDDR5X-PIM. Công nghệ xử lý trong bộ nhớ đưa một phần phép tính vào thiết bị bộ nhớ, giảm các lần truyền dữ liệu lặp lại giữa bộ nhớ và bộ xử lý riêng biệt. Samsung cho biết thiết kế của hãng tích hợp các đơn vị xử lý vào từng ngân hàng bộ nhớ.
Trong cuộc đánh giá dùng Llama 3.1 8B trên bộ tăng tốc AI Samsung Edge, Samsung cho biết băng thông hiệu dụng cao hơn tới tám lần so với LPDDR5X thông thường, số token tạo ra mỗi giây tăng tới ba lần và thời gian chạy giảm tới 2,2 lần. Những con số này áp dụng cho bộ tăng tốc và mô hình đó, không phải HBM5 hay phần trình diễn bộ nhớ cùng AMD.
SOCAMM2, cũng được giới thiệu tại sự kiện, là mô-đun bộ nhớ máy chủ dựa trên LPDDR. Các sản phẩm trưng bày cho thấy chiến lược tăng tốc của Samsung bao gồm cả bộ nhớ cho bộ tăng tốc lẫn công nghệ bộ nhớ tiêu thụ điện năng thấp hơn, dù trang hội nghị không cung cấp kết quả chuẩn đối chiếu tương đương cho từng sản phẩm.
Hợp tác với AMD hướng đến dung lượng bộ nhớ linh hoạt
Samsung và AMD đã trình diễn mở rộng bộ nhớ CXL bằng công nghệ CMM-D của Samsung. CXL, viết tắt của Compute Express Link, kết nối bộ xử lý và các thiết bị khác với bộ nhớ bổ sung, cho phép hệ thống mở rộng dung lượng vượt quá bộ nhớ được lắp trực tiếp.
CMM-D là mô-đun bộ nhớ DRAM dựa trên CXL. Với cấu hình gộp chung, nhiều hệ thống có thể sử dụng dung lượng từ các tài nguyên bộ nhớ được kết nối, thay vì để dung lượng đó cố định cho từng máy chủ. Samsung cho biết hợp tác với AMD đã xác thực CXL như một phương thức mở rộng dung lượng và băng thông bộ nhớ, đồng thời giảm thời gian lõi CPU phải chờ dữ liệu.
Vấn đề càng trở nên cấp thiết khi các tác nhân AI chạy nhiều mô hình hoặc tác vụ. Theo mô tả chính thức của Samsung, khối lượng công việc của tác nhân có thể làm mức sử dụng CPU tăng mạnh, trong khi dung lượng bộ nhớ không theo kịp số lượng lõi xử lý.
Một phần trình diễn riêng về gộp bộ nhớ CMM-D sử dụng cơ chế phân bổ linh hoạt giữa nhiều phiên bản mô hình ngôn ngữ lớn trên máy chủ GPU. Samsung cho biết thời gian chờ đến token đầu tiên, hay TTFT, giảm tới 38% và thông lượng hữu ích tăng tới 3,3 lần so với phân bổ tĩnh. TTFT đo thời gian chờ trước khi câu trả lời bắt đầu; thông lượng hữu ích đo lượng công việc có ích được hoàn thành theo tiêu chí đánh giá.
Không nên xem những kết quả này là số liệu của chính phần trình diễn với AMD. Trang chính thức mô tả riêng việc xác thực cùng AMD và bài đánh giá phân bổ linh hoạt. Trang này cũng không cung cấp đủ chi tiết để xác định mức cải thiện sẽ thay đổi ra sao với các mô hình, cấu hình máy chủ hoặc mục tiêu dịch vụ khác nhau.
Bộ nhớ đệm KV kết nối mở rộng bộ nhớ với lưu trữ
Một mắt xích quan trọng giữa kế hoạch về bộ nhớ và lưu trữ của Samsung là bộ nhớ đệm khóa-giá trị, thường gọi là KV cache. Bộ nhớ này lưu thông tin trung gian được tạo ra khi mô hình ngôn ngữ xử lý văn bản, giúp mô hình dùng lại kết quả thay vì tính toán lại cho mỗi token mới.
Các cuộc hội thoại dài, ngữ cảnh lớn hơn và nhiều người dùng đồng thời có thể khiến những bộ nhớ đệm này chiếm dụng lượng bộ nhớ đáng kể. Samsung đề xuất một hệ thống phân tầng, trong đó bộ nhớ CXL mở rộng dung lượng sẵn có còn SSD lưu dữ liệu bộ nhớ đệm không cần nằm ở tầng bộ nhớ nhanh nhất.
Trang hội nghị chính thức mô tả một triển khai thực tế tại cơ sở Samsung Semiconductor ở Mỹ, phục vụ một tác nhân AI hỗ trợ viết mã nội bộ và các ứng dụng khác. Samsung cho biết việc bổ sung tầng bộ nhớ tổng hợp L3.5 thông qua giải pháp AI Memory Node đã giúp mức sử dụng KV cache tăng từ năm đến bảy lần.
L3.5 là tên gọi của tầng bổ sung đó, không phải tuyên bố rằng mọi máy chủ đều dùng chung một kiến trúc bộ nhớ đệm. Triển khai này có sự tham gia của Phòng thí nghiệm Giải pháp Bộ nhớ Samsung, nhóm Tích hợp Nền tảng AI DSA và SGLang. Kết quả về mức sử dụng khác với cả bài đánh giá phân bổ linh hoạt lẫn các số liệu hiệu năng LPDDR5X-PIM.
Lịch hội nghị còn có phiên ngày 13 tháng 10 về kết hợp gộp bộ nhớ CXL với lưu trữ SSD để chuyển KV cache sang nơi lưu trữ, do kiến trúc sư hệ thống Jinin So và kỹ sư trưởng Youngha Choi trình bày. Sự kết hợp này cho thấy chiến lược không chỉ là nâng cấp dung lượng: cần có phần mềm sắp xếp và truy xuất dữ liệu giữa bộ nhớ với lưu trữ mà không gây độ trễ quá mức.
SSD đảm nhiệm dung lượng, làm mát và sắp xếp dữ liệu
Chiến lược lưu trữ bền vững của Samsung tập trung vào SSD doanh nghiệp và NAND flash dung lượng cao. Lưu trữ bền vững là khả năng giữ lại dữ liệu ngoài trạng thái làm việc tạm thời của một phép tính, giúp hệ thống AI truy xuất bộ dữ liệu, tệp mô hình và thông tin bộ nhớ đệm đã lưu khi cần.
PM1763 được giới thiệu là SSD doanh nghiệp PCIe Gen6, có tốc độ đọc tuần tự lên tới 28,4 GB/s và hiệu suất sử dụng điện cao hơn tới 1,8 lần so với thế hệ tiền nhiệm. Trong phần trình diễn làm mát bằng chất lỏng, phiên bản E1.S được đặt tiếp xúc trực tiếp với tấm lạnh để tản nhiệt. Trang chính thức không cung cấp đầy đủ điều kiện thử nghiệm cho phép so sánh hiệu năng.
BM1773 được liệt kê là SSD E3.S với dung lượng lưu trữ QLC 256 TB. QLC, hay ô nhớ bốn mức, lưu trữ bốn bit trong mỗi ô flash, hỗ trợ dung lượng cao. Các bài tường thuật cũng đề cập Samsung tiếp tục phát triển NAND QLC dung lượng cao và công nghệ sắp xếp dữ liệu linh hoạt.
Samsung trình diễn các tối ưu hóa KV cache tích hợp vào LMCache. Công nghệ Sắp xếp Dữ liệu Linh hoạt (FDP) giúp tổ chức vị trí ghi dữ liệu nhằm giảm khuếch đại ghi, tức lượng ghi nội bộ bổ sung mà SSD thực hiện ngoài dữ liệu máy chủ gửi đến.
Phần trình diễn cũng sử dụng kích thước truyền dữ liệu tối đa NVMe lớn hơn để giảm khối lượng công việc của CPU máy chủ. Samsung cho biết các kỹ thuật này hữu ích cho cả lưu trữ bộ nhớ đệm trong một nút máy chủ lẫn tài nguyên bộ nhớ đệm được chia sẻ giữa một nhóm máy chủ. Trang sự kiện không nêu mức cải thiện định lượng của riêng các tối ưu hóa này.
Đưa phép tính đến gần dữ liệu được lưu trữ
Phần trình diễn cơ sở dữ liệu vector của Samsung đưa ra một cách khác để giảm việc di chuyển dữ liệu. Cơ sở dữ liệu vector lưu các biểu diễn số của thông tin rồi so sánh chúng để tìm những mục tương đồng; đây là bước phổ biến khi ứng dụng AI truy xuất tài liệu liên quan đến yêu cầu.
Phần thử nghiệm ý tưởng NCVS chuyển việc tính khoảng cách vector vào SSD. Thay vì gửi một vector 4KB đến máy chủ để so sánh, thiết bị trả về kết quả khoảng cách dài bốn byte. Samsung cho biết lưu lượng truyền đến máy chủ giảm tới 22 lần so với cách xử lý thông thường trên máy chủ, trong khi thông lượng tìm kiếm tăng lên khi bổ sung thêm SSD.
Các con số bốn byte và 4KB mô tả kích thước của từng kết quả và vector; chúng không có nghĩa toàn bộ ứng dụng giảm lưu lượng theo cùng tỷ lệ. Mức giảm được báo cáo, tối đa 22 lần, là kết quả so sánh tổng thể đã đo được. Samsung xác định NCVS là sản phẩm thử nghiệm ý tưởng, chưa phải sản phẩm được cung cấp rộng rãi.
Phần trình diễn AiSIO xử lý hoạt động nhập xuất của bộ nhớ thông qua một giao diện phần mềm chung, hỗ trợ các thao tác do GPU khởi tạo, kết nối trực tiếp giữa các thiết bị và thao tác thông thường do CPU khởi tạo. Samsung cho biết công nghệ này đạt 100 triệu thao tác nhập xuất mỗi giây và giúp tải mô hình ngôn ngữ từ trạng thái khởi động nguội nhanh hơn tới mười lần khi sử dụng OpenDS.
Các chỉ số này mô tả những công việc khác nhau. Tốc độ đọc tuần tự liên quan đến truyền dữ liệu liên tục, số thao tác nhập xuất mỗi giây đếm các yêu cầu lưu trữ, còn thời gian tải khi khởi động nguội đo tốc độ đưa mô hình vào trạng thái sẵn sàng. Không chỉ số nào có thể thay thế trực tiếp cho bài đánh giá số lượng yêu cầu người dùng mà một dịch vụ AI hoàn chỉnh có thể xử lý.
Thử nghiệm với khách hàng và sản phẩm đúc chip mở rộng phạm vi giới thiệu
Samsung MAX Lab nhằm thu hút khách hàng tham gia sớm hơn vào quá trình phát triển. Khách hàng có thể thử nghiệm các công nghệ như PIM, CMM-D và SSD thế hệ mới dưới những khối lượng công việc AI thực tế trước khi thương mại hóa, sau đó cung cấp yêu cầu hệ thống để đưa vào thiết kế sản phẩm.
Cách tiếp cận này giải quyết một vấn đề thực tiễn xuyên suốt các phần trình diễn tại hội nghị: linh kiện nhanh hơn chỉ đem lại giá trị nếu phần mềm và phần cứng xung quanh có thể tận dụng nó. Nhóm Global Open-ecoSystem của Samsung tham gia phát triển mã nguồn mở và tiêu chuẩn hóa trong ngành, còn chương trình sự kiện có các phiên về khung phần mềm, xử lý lệnh lưu trữ và quản lý bộ nhớ.
Samsung cũng trình diễn lưu trữ tổng hợp với khả năng di chuyển trực tiếp và quản lý SSD ảo thông qua NVMe tiêu chuẩn. Mô tả chính thức của hãng cho biết giải pháp này hướng đến lưu trữ dùng chung cho nhiều bên thuê, với chất lượng dịch vụ có thể được kiểm soát, tức khả năng điều chỉnh dịch vụ mà mỗi khối lượng công việc nhận được.
Triển lãm không chỉ có bộ nhớ. Các bài tường thuật đề cập tấm wafer bộ xử lý ngôn ngữ Groq được sản xuất bằng quy trình 4nm của Samsung Foundry, hệ thống Groq 3 LPX được một số bài mô tả là hệ thống Nvidia, và các tấm wafer sử dụng quy trình gate-all-around 2nm của Samsung. Những sản phẩm trưng bày này giới thiệu năng lực sản xuất cùng với bộ nhớ và lưu trữ, nhưng không xác nhận hợp đồng sản xuất mới hay sản lượng xuất xưởng.
Quan hệ hợp tác được phát triển qua nhiều tháng
Phần trình diễn với AMD tiếp nối quá trình hợp tác trước đó, chứ không diễn ra riêng lẻ. Các bài tường thuật cho biết hai bên đã ký biên bản ghi nhớ vào tháng 3, bao quát công nghệ tính toán và bộ nhớ AI thế hệ mới, sau đó tiếp tục thảo luận trong chuyến thăm Hàn Quốc ngày 7 tháng 10 của CEO AMD Lisa Su.
Diễn biến được tường thuật và các phiên hội nghị dự kiến diễn ra theo trình tự sau:
- Tháng 3 năm 2026: Samsung và AMD ký biên bản ghi nhớ hợp tác; Samsung cũng giới thiệu công nghệ tại Nvidia GTC.
- Tháng 6 và tháng 8 năm 2026: Samsung lần lượt giới thiệu công nghệ tại COMPUTEX và hội nghị Future of Memory and Storage.
- Ngày 7 tháng 10 năm 2026: Lisa Su thăm Hàn Quốc và gặp Phó chủ tịch Hội đồng quản trị Samsung DS Division Jeon Young-hyun để thảo luận hợp tác về bộ nhớ và tính toán; các bài tường thuật cũng đề cập thảo luận về sản xuất chip.
- Ngày 12 tháng 10 năm 2026: Hội nghị khai mạc, phiên trình bày dành cho lãnh đạo của Shim dự kiến diễn ra trong ngày.
- Từ ngày 13 đến 15 tháng 10 năm 2026: Chương trình của Samsung có các phiên về phân tầng KV cache, tối ưu lưu trữ và kiến trúc bộ nhớ CXL dùng chung.
Samsung tham gia với tư cách nhà tài trợ Kim cương. Các bài tường thuật không thống nhất liệu nên tính thời điểm công bố chiến lược là ngày 12 tháng 10 theo giờ địa phương hay tuyên bố của công ty ngày 13 tháng 10. Hai mốc này có thể phản ánh những giai đoạn khác nhau của cùng sự kiện. Một bài viết đặt hội nghị tại San Francisco, trong khi lịch chính thức của Samsung xác định địa điểm là trung tâm hội nghị ở San Jose.
Quy mô thị trường không quyết định mức độ sẵn sàng thương mại
Nghiên cứu ngành được trích dẫn cho biết Samsung đứng đầu trong quý II năm 2026, chiếm 39% doanh thu DRAM toàn cầu và 29,3% thị trường NAND flash. Counterpoint Research được nêu là nguồn của số liệu DRAM, còn TrendForce là nguồn của số liệu NAND. Đây là các chỉ số thị phần, không phải thị phần trong những lĩnh vực mới nổi như CXL hay xử lý trong bộ nhớ.
Omdia được dẫn nguồn với dự báo Samsung sẽ sản xuất số tấm wafer DRAM và NAND lớn nhất ngành trong năm. Một ước tính riêng cho rằng công suất DRAM hằng năm của hãng vào khoảng 8,175 triệu wafer, quy đổi theo wafer 300mm. Công suất không đồng nghĩa với sản lượng thực tế, và cả hai con số đều không cho biết bao nhiêu sản lượng được dành cho các công nghệ giới thiệu tại OCP.
Một bài tường thuật còn đưa ra các số liệu sơ bộ cao bất thường cho quý III, công bố ngày 8 tháng 10: doanh thu 195 nghìn tỷ won và lợi nhuận hoạt động 107,4 nghìn tỷ won, tăng 782,5% so với cùng kỳ năm trước. Các số liệu này không được xác nhận bằng thông cáo tài chính chính thức trong nội dung được dẫn ở đây, nên không thể xem là bằng chứng đã được xác thực về lợi nhuận từ các công nghệ tại hội nghị.
Cạnh tranh cũng đang mở rộng ra ngoài HBM. Các bài tường thuật mô tả Hệ thống Tủ AI Tập trung vào Bộ nhớ, hay MARS, của SK hynix là một nhóm bộ nhớ CXL dùng chung trong tủ máy chủ. Cách tiếp cận này tương đồng với nỗ lực của Samsung nhằm cho phép các hệ thống dùng chung bộ nhớ dự phòng, dù chưa có kết quả chuẩn đối chiếu tương đương để xác định giải pháp nào hoạt động tốt hơn.
Mục tiêu Samsung tuyên bố là nâng cao năng lực cạnh tranh của HBM, DDR5 máy chủ và SSD doanh nghiệp. Những vấn đề thương mại chưa được làm rõ gồm thời điểm HBM5 sẵn sàng, giá bán, mức độ tiếp nhận rộng rãi của khách hàng và việc xác nhận độc lập các tuyên bố hiệu năng. Chương trình hội nghị nêu ngày trình diễn và thảo luận, chứ không đưa ra thời hạn phát hành chắc chắn cho từng công nghệ.
Điểm chính
- Chiến lược OCP 2026 của Samsung kết hợp bộ nhớ nhanh hơn, mở rộng dung lượng bằng CXL và lưu trữ bền vững trên SSD.
- Hợp tác với AMD sử dụng công nghệ bộ nhớ CMM-D để đáp ứng nhu cầu bộ nhớ ngày càng tăng của AI.
- Một phần trình diễn gộp bộ nhớ linh hoạt riêng biệt cho thấy thời gian chờ đến token đầu tiên giảm tới 38% và thông lượng hữu ích tăng 3,3 lần.
- Kết quả đánh giá LPDDR5X-PIM cho thấy hiệu năng suy luận tăng tới ba lần trên bộ tăng tốc AI Samsung Edge.
- Lưu trữ PM1763, tối ưu KV cache và xử lý ngay trong SSD nhắm đến những hạn chế khác nhau về luân chuyển dữ liệu.
- Thông tin tại hội nghị chưa xác lập thời điểm xuất xưởng HBM5 hay khả năng thương mại hóa rộng rãi.