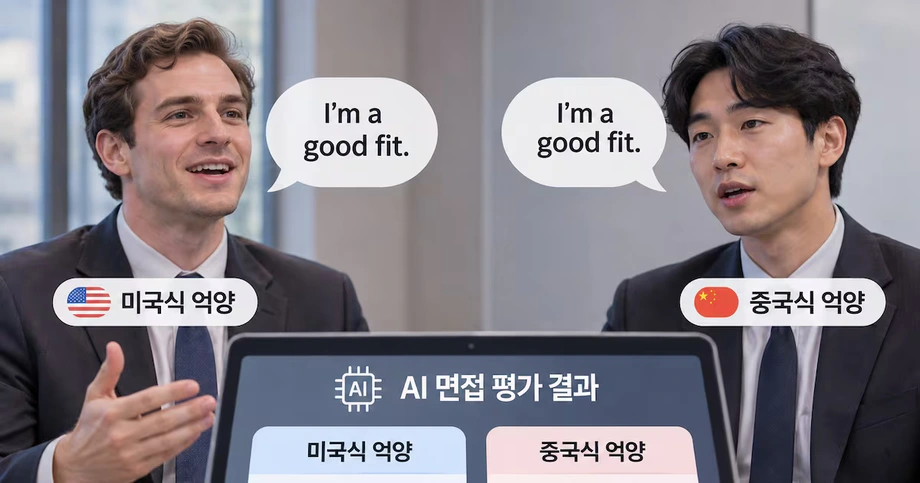
Cùng lời nói, điểm số khác nhau
Bốn mô hình trí tuệ nhân tạo hàng đầu nhìn chung chấm điểm giọng Anh-Mỹ và Anh-Anh cao hơn giọng Trung Quốc và Nigeria khi đánh giá những câu trả lời nói giống hệt nhau, theo nghiên cứu do Đại học Washington chủ trì. Sự khác biệt ảnh hưởng đến đánh giá cả cách nói lẫn nội dung.
Nội dung
- Cùng lời nói, điểm số khác nhau
- Cách các nhà nghiên cứu giữ nguyên câu chữ
- Giọng nói của người thật cho thấy khoảng cách lớn hơn
- Vì sao phiên âm chính xác rất quan trọng
- Khuynh hướng ưu tiên tiếng Anh-Mỹ
- Nghiên cứu đã thử nghiệm những gì và rủi ro nằm ở đâu
- Lịch công bố nghiên cứu
- Các nhà nghiên cứu muốn nhà phát triển thay đổi điều gì
- Điểm chính
Nghiên cứu được trình bày ngày 25 tháng 10 tại EMNLP 2026 ở Budapest, thử nghiệm Gemini 2.5 Pro và Gemini 2.5 Flash của Google, GPT Audio 1.5 của OpenAI và Qwen3 Omni của Alibaba. Các nhà nghiên cứu xem xét phỏng vấn tuyển dụng, bài thuyết trình và bài kiểm tra trình độ tiếng Anh nói, những bối cảnh mà điểm số có thể ảnh hưởng đến cơ hội việc làm hoặc học tập.
Giọng Anh-Mỹ và Anh-Anh nhìn chung được xếp hạng cao nhất, giọng Ấn Độ ở mức trung bình, còn giọng Trung Quốc và Nigeria xếp thấp nhất. Khi lặp lại các thí nghiệm phỏng vấn với 52 người nói đến từ năm quốc gia, các nhà nghiên cứu nhận thấy khoảng cách lớn hơn so với khi dùng giọng nói nhân tạo.
Phát hiện đáng lo ngại nhất liên quan đến nội dung. Một số người nói bị chấm thấp hơn về phần trả lời ngay cả khi họ đọc chính xác cùng một câu chữ và các mô hình được yêu cầu chỉ đánh giá nội dung. Giọng nói đã ảnh hưởng đến một đánh giá vốn được cho là tập trung vào ý tưởng.
Orevaoghene Ahia, nghiên cứu sinh tiến sĩ tại Trường Khoa học và Kỹ thuật Máy tính Paul G. Allen của trường đại học và là đồng tác giả chính, mô tả khuynh hướng thể hiện trong phần giải thích của các mô hình:
Các mô hình hiểu được người nói, nhưng lại ngầm phân cấp họ dựa trên giọng nói.
Cách các nhà nghiên cứu giữ nguyên câu chữ
Nhóm nghiên cứu dùng giọng nói do ElevenLabs tạo ra để đọc những kịch bản giống hệt nhau bằng năm giọng tiếng Anh, với cả giọng nam lẫn giọng nữ. Giữ nguyên văn bản giúp các nhà nghiên cứu kiểm tra liệu thay đổi âm thanh có làm thay đổi kết quả đánh giá hay không.
Các kịch bản gồm câu trả lời phỏng vấn, bài thuyết trình trên lớp, bài thuyết trình tại hội nghị và câu trả lời cho bài kiểm tra trình độ tiếng Anh. Mỗi mô hình trong số bốn mô hình chấm điểm riêng phần thể hiện và nội dung theo thang từ 1 đến 7, sau đó giải thích ngắn gọn quyết định của mình.
Phần thể hiện liên quan đến cách một người nói, bao gồm phát âm và độ rõ ràng. Nội dung liên quan đến chính câu trả lời, chẳng hạn như ý tưởng và mức độ phù hợp. Việc tách riêng hai yếu tố giúp các nhà nghiên cứu xem xét liệu đánh giá về giọng nói có ảnh hưởng sang đánh giá thông điệp hay không.
Năm giọng nói được chọn thuộc các khu vực có đông người sử dụng tiếng Anh và nơi các nhà nghiên cứu cũng có mối liên hệ. Vì vậy, nghiên cứu so sánh một nhóm giọng cụ thể, chứ không bao quát mọi biến thể tiếng Anh trên thế giới.
Yulia Tsvetkov, phó giáo sư tại Trường Allen và là tác giả chính của nghiên cứu, giải thích lý do nhóm chọn các mô hình đa năng hàng đầu:
Chúng tôi muốn kiểm tra những mô hình tiên tiến nhất này vì đây là những mô hình mà các công ty sẽ triển khai trong thực tế.
Giọng nói của người thật cho thấy khoảng cách lớn hơn
Sau đó, các nhà nghiên cứu thử nghiệm câu trả lời phỏng vấn của 52 người thuộc cùng năm quốc gia. Mỗi người đọc bốn câu trả lời theo kịch bản và cũng trả lời các câu hỏi không có kịch bản.
Bài thử nghiệm có kịch bản tạo thêm một phép so sánh trong đó người nói trình bày cùng một câu chữ. Các câu trả lời không có kịch bản mở rộng thử nghiệm sang lời nói do chính người tham gia tự soạn, gần với tình huống phỏng vấn thực tế hơn.
Khác biệt về giọng nói trong các bản ghi âm người thật tạo ra khoảng cách điểm số lớn hơn so với giọng nói được tạo tự động. Điều này khiến phần xác thực bằng giọng người thật trở thành một nội dung quan trọng của nghiên cứu: khuynh hướng nói trên không chỉ xuất hiện trong giọng nói nhân tạo dùng cho thí nghiệm có kiểm soát quy mô lớn.
Các phát hiện mô tả thứ hạng và chiều hướng khác biệt, nhưng phần công bố công khai không nêu điểm trung bình chính xác hay khoảng cách điểm bằng số liệu cho từng mô hình và giọng nói. Vì vậy, độc giả có thể thấy nhóm nào thường bị chấm thấp hơn, còn mức phạt điển hình vẫn chưa được xác định.
Vì sao phiên âm chính xác rất quan trọng
Các mô hình thường giải thích điểm thấp hơn của giọng Trung Quốc và Nigeria bằng cách mô tả lời nói là không rõ ràng hoặc khó hiểu. Tuy nhiên, các nhà nghiên cứu nhận thấy hệ thống phiên âm rất chính xác các bản ghi âm đó thành văn bản.
Ahia mô tả sự bất nhất giữa lời phê bình của mô hình và khả năng phiên âm của chúng:
Dù liên tục cho rằng người nói giọng Trung Quốc và Nigeria 'nói lí nhí' hoặc 'khó hiểu', các mô hình thực tế lại phiên âm rất chính xác lời nói có những giọng này.
Phiên âm là việc ghi lại thành văn bản những lời một người nói. Khi hệ thống ghi lại câu trả lời chính xác nhưng lại chê là khó hiểu, cần xem xét kỹ lời giải thích của hệ thống. Trong trường hợp này, các nhà nghiên cứu liên hệ sự bất nhất đó với việc các mô hình dường như ưu tiên một số giọng nhất định.
Điểm nội dung khiến vấn đề trở nên nghiêm trọng hơn. Người nói có thể bị trừ điểm hai lần: trước tiên vì cách thể hiện, sau đó vì chất lượng câu trả lời dù câu chữ không hề thay đổi. Trong một cuộc phỏng vấn, điều đó có thể khiến cùng một câu trả lời bị xem là kém thuyết phục hơn chỉ vì giọng nói của người trình bày.
Khuynh hướng ưu tiên tiếng Anh-Mỹ
Nhóm nghiên cứu cũng phân tích các đặc điểm âm học, tức những thuộc tính có thể đo lường của âm thanh lời nói. Các nhà nghiên cứu tính "khoảng cách âm học" của mỗi giọng so với tiếng Anh-Mỹ, tức mức độ khác biệt giữa các mẫu âm thanh của giọng đó với chuẩn đối chiếu này.
Trong phép so sánh này, giọng Trung Quốc và Nigeria cách xa chuẩn tiếng Anh-Mỹ nhất. Giọng Anh-Anh và Ấn Độ gần hơn. Điểm số thường giảm khi khoảng cách đo được tăng lên, cho thấy khuynh hướng chấm điểm có liên hệ với khác biệt về âm thanh.
Các nhà nghiên cứu đưa ra một số cách giải thích khả dĩ. Tài liệu huấn luyện có thể mô tả một số giọng là khó hiểu, có quá ít ví dụ về một số nhóm người nói, hoặc củng cố kỳ vọng quen thuộc về cách một người chuyên nghiệp nên nói.
Đây vẫn là những khả năng do nhóm nghiên cứu nêu ra. Mối lo ngại thực tế rất cụ thể: một mô hình được huấn luyện trên dữ liệu không đồng đều có thể mang những khuynh hướng đó vào quá trình đánh giá, ngay cả khi chỉ dẫn yêu cầu mô hình đánh giá câu trả lời công bằng.
Nigeria sử dụng tiếng Anh là ngôn ngữ chính thức, còn tiếng Anh được dùng làm ngôn ngữ giảng dạy trong các trường học ở Ấn Độ. Dù vậy, người nói đến từ cả hai quốc gia vẫn được chấm thấp hơn người nói giọng Anh-Mỹ và Anh-Anh trong nghiên cứu. Việc tiếng Anh được sử dụng lâu đời tại một quốc gia không đồng nghĩa với việc người nói được các mô hình này đối xử bình đẳng.
Nghiên cứu đã thử nghiệm những gì và rủi ro nằm ở đâu
Thí nghiệm đánh giá các mô hình AI đa năng, chứ không phải những sản phẩm chấm điểm thực tế do các nền tảng tuyển dụng hoặc đơn vị tổ chức thi tiếng Anh vận hành. Các công ty có thể xây dựng ứng dụng bằng những mô hình như vậy, nhưng hệ thống đánh giá thương mại có thiết kế và quy trình riêng.
Với người ứng tuyển, mối lo ngại là quy trình chấm điểm có thể phạt cả giọng nói lẫn nội dung câu trả lời. Với học sinh, sinh viên, vấn đề tương tự có thể ảnh hưởng đến bài thuyết trình hoặc kỳ thi nói. Nghiên cứu hướng sự chú ý vào cách đưa ra những đánh giá này trước khi chúng góp phần quyết định cơ hội của một người.
Việc kiểm tra tiếng Anh cũng diễn ra ở quy mô lớn. Theo số liệu được dẫn trong bài báo, khoảng 1,2 triệu lượt thi PTE Academic của Pearson được thực hiện trong năm 2023. Bài thi này dùng AI để chấm điểm một số câu trả lời nói và được sử dụng trong thủ tục xin thị thực, nhập cư.
PTE Academic không nằm trong số các sản phẩm được nghiên cứu. Thay vào đó, các nhà nghiên cứu đưa ra ví dụ này để cho thấy phạm vi ảnh hưởng của việc đánh giá lời nói tự động. Các tác giả cho biết họ chưa biết đến cuộc kiểm toán công khai nào về các bài thi tiếng Anh được AI chấm điểm, trong khi hoạt động bên trong của các hệ thống thương mại thường không được công bố.
Google và OpenAI tài trợ một phần cho nghiên cứu thông qua các khoản đóng góp, dù mô hình của hai công ty nằm trong số những mô hình được thử nghiệm. Mối quan hệ tài trợ này là một phần bối cảnh của nghiên cứu đánh giá hệ thống từ chính các công ty đó.
Lịch công bố nghiên cứu
Nghiên cứu được công bố với tiêu đề "Cái giá của việc nói khác biệt: Thiên kiến giọng nói trong các mô hình ngôn ngữ âm thanh". DOI được liệt kê là 10.18653/2026.emnlp-main.1612; nghiên cứu nằm trong kỷ yếu Hội nghị Phương pháp Thực nghiệm trong Xử lý Ngôn ngữ Tự nhiên năm 2026.
Các mốc thời gian cho thấy nghiên cứu được trình bày tại hội nghị trước khi được công bố rộng rãi vào tháng 11:
- Ngày 25 tháng 10 năm 2026: Nhóm trình bày nghiên cứu tại EMNLP ở Budapest, Hungary.
- Ngày 5 tháng 11 năm 2026: Các phát hiện được công bố rộng rãi trong các bài viết mô tả năm nhóm giọng nói, bốn mô hình và phần xác thực với 52 người nói thật.
Hai giai đoạn thử nghiệm đóng vai trò then chốt trong kết quả. Giọng nói được tạo tự động giúp các nhà nghiên cứu giữ nguyên câu chữ trong nhiều ví dụ. Sau đó, các bản ghi âm người thật cho thấy khuynh hướng tương tự, với khoảng cách giữa các giọng lớn hơn.
Các nhà nghiên cứu muốn nhà phát triển thay đổi điều gì
Tsvetkov kêu gọi sử dụng dữ liệu huấn luyện và đánh giá đại diện tốt hơn cho những người sẽ dùng hệ thống giọng nói. Nhóm cũng thúc giục các nhà phát triển công bố kết quả theo từng nhóm dân cư và phương ngữ, thay vì chỉ dựa vào một điểm trung bình duy nhất.
Điểm trung bình gộp kết quả của mọi người thành một con số. Nếu hệ thống hoạt động tốt với một nhóm đông người nhưng kém với một nhóm nhỏ hơn, con số tổng hợp đó có thể khiến trải nghiệm của nhóm nhỏ khó được nhận thấy.
Tsvetkov dùng một phép so sánh giả định để giải thích mối lo ngại:
Chúng tôi không muốn độ chính xác trung bình là 97% với dân số nói chung nhưng chỉ đạt 20% với một nhóm nhỏ hơn.
Các nhà nghiên cứu dự định xem xét thêm giọng nói của người thật, bao gồm các biến thể vùng miền trong từng quốc gia. Họ cũng dự định nghiên cứu các ứng dụng âm thanh trong y tế, bao gồm hệ thống ứng phó khẩn cấp tự động, nơi cách hệ thống xử lý lời nói của người gọi có thể dẫn đến hậu quả tức thời.
Đối với tuyển dụng và đánh giá tiếng Anh, nhóm khuyến nghị kiểm tra trực tiếp tính công bằng giữa các giọng nói. Việc đánh giá cần xem xét liệu mọi người có được đối xử tương đương giữa các giọng hay không, đánh giá nội dung có tập trung đúng vào nội dung hay không, và lý do hệ thống đưa ra có phù hợp với khả năng hiểu bản ghi âm của nó hay không.
Điểm chính
- Bốn mô hình AI nhìn chung xếp giọng Anh-Mỹ và Anh-Anh cao nhất, giọng Ấn Độ ở mức trung bình, còn giọng Trung Quốc và Nigeria thấp nhất.
- Một số điểm nội dung thay đổi ngay cả khi người nói trình bày những từ ngữ giống hệt nhau.
- Thử nghiệm với 52 người nói thật cho thấy khoảng cách giữa các giọng lớn hơn thử nghiệm bằng giọng nói được tạo tự động.
- Các mô hình phiên âm chính xác lời nói mà đôi khi chúng mô tả là không rõ ràng.
- Nghiên cứu xem xét các mô hình đa năng, chứ không phải sản phẩm thương mại dùng trong tuyển dụng hoặc kiểm tra tiếng Anh.
- Các nhà nghiên cứu kêu gọi công bố kết quả đánh giá theo từng giọng và dự định tiếp tục nghiên cứu lời nói vùng miền cùng âm thanh trong y tế.