111 đóng góp tư nhân phơi bày khoảng trống trong tham vọng AI của Đài Loan
Bộ sưu tập dữ liệu huấn luyện AI của chính phủ Đài Loan đã tích lũy 7.161 mục dữ liệu, nhưng chỉ 111 mục đến từ các cá nhân, tổ chức đóng góp tư nhân. Con số này chiếm khoảng 1,6% tổng số, một tỷ lệ nhỏ đối với dự án nhằm giúp trí tuệ nhân tạo hiểu ngôn ngữ, văn hóa và đời sống thường nhật của Đài Loan.
Nội dung
- 111 đóng góp tư nhân phơi bày khoảng trống trong tham vọng AI của Đài Loan
- Kho dữ liệu của chính phủ gồm những gì
- Vì sao ngôn ngữ địa phương quan trọng
- Khiếu nại hình sự làm thay đổi cách tính toán
- Bản quyền liên quan đến huấn luyện AI ra sao
- Cấp phép tự nguyện, không chuyển giao quyền sở hữu
- Hợp tác có trả phí đã có một tiền lệ nhỏ
- Ngoại lệ pháp lý và giấy phép tập thể là hai phương án cạnh tranh
- TAIDE cho thấy cả quyền tiếp cận lẫn nguồn lực đều quan trọng
- Điểm chính
Bộ Kỹ thuật số khai trương Kho ngữ liệu huấn luyện AI chủ quyền Đài Loan ngày 24/12/2025, với hơn 200 cơ quan chính phủ đóng góp hơn 2.000 bộ dữ liệu, gồm 600 triệu token. Token là những đơn vị văn bản nhỏ mà hệ thống AI xử lý, đôi khi là một ký tự, đôi khi là một phần của từ.
Sự tham gia của chính phủ giúp xây dựng quy mô cho kho dữ liệu. Thu hút các nhà xuất bản, tác giả, nền tảng giáo dục và tổ chức tin tức lại là một bài toán khó hơn: các nhà phát triển cần được phép sao chép những bài viết có giá trị để huấn luyện AI, trong khi chủ sở hữu nội dung muốn được trả tiền và kiểm soát cách tác phẩm của họ được sử dụng.
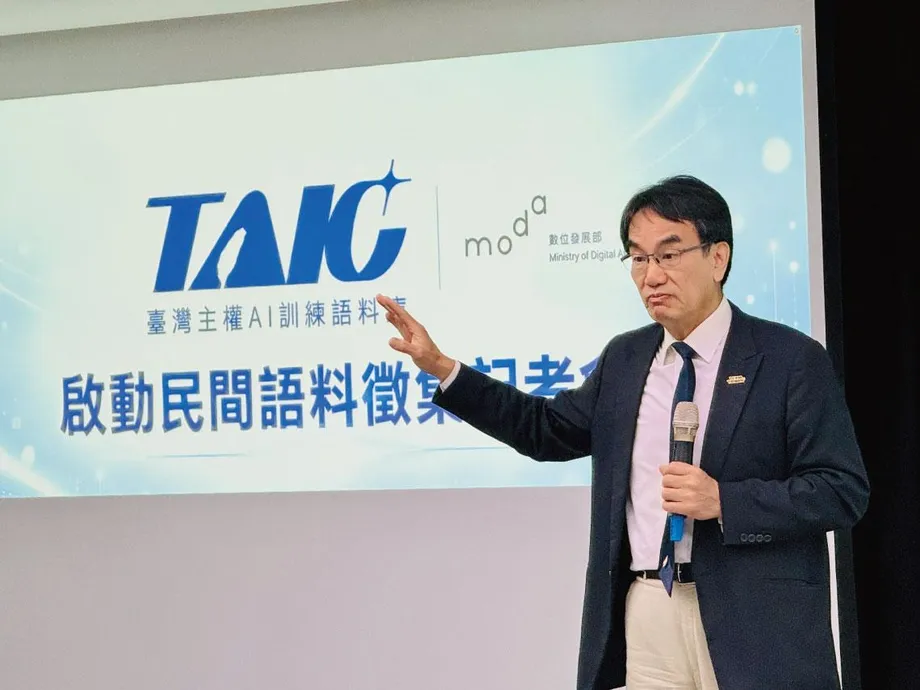
Tại phiên điều trần lập pháp ngày 14/10/2026, Bộ trưởng Kỹ thuật số Lin Yi-jing cho biết việc tham gia của khối tư nhân là tự nguyện và chính phủ muốn các công ty AI lớn, đặc biệt là các công ty Mỹ, trả tiền cho nội dung huấn luyện. Nội dung tin tức hiện không thuộc chương trình thu thập tư liệu tư nhân.
Ý nghĩa thực tế của vấn đề không chỉ nằm ở quy mô cơ sở dữ liệu. Một mô hình được huấn luyện bằng văn bản của Đài Loan có thể học từ vựng địa phương, giải thích truyền thống văn hóa và trả lời câu hỏi có tính đến các thể chế của Đài Loan. Tuy nhiên, các tác giả và tổ chức tạo ra những tư liệu đó cũng phụ thuộc vào giá trị thương mại của chúng. Đài Loan đang tìm cách mở rộng quyền tiếp cận tác phẩm, đồng thời quyết định ai sẽ trả tiền, giấy phép bao gồm những gì và quy định bản quyền cần được làm rõ ở đâu.
Kho dữ liệu của chính phủ gồm những gì
Thông báo khai trương hồi tháng 12 của bộ mô tả kho dữ liệu bao quát ngôn ngữ, văn hóa, giáo dục, sinh học và địa lý. Kho dữ liệu khai thác nguồn dữ liệu mở của chính phủ trong hơn mười năm và cho phép người dùng tìm kiếm, tải xuống tư liệu.
Bộ Văn hóa cung cấp các bộ dữ liệu về nghệ thuật công cộng và tài sản văn hóa. Bộ Giáo dục đóng góp dữ liệu từ điển bao gồm tiếng Đài Loan, tiếng Khách Gia và tiếng Quan thoại. Những nguồn tư liệu này cung cấp cho nhà phát triển thông tin về ý nghĩa và cách dùng tại địa phương, cùng với thông tin về địa điểm, sự vật và truyền thống.
Mô tả chương trình kho ngữ liệu của bộ cũng nêu tên Hội đồng Các dân tộc Bản địa và Hội đồng Công tác Khách Gia trong số các cơ quan tham gia. Các chủ đề dự kiến gồm lịch sử, di sản văn hóa, du lịch và văn hóa địa phương. Bộ cho biết văn bản huấn luyện hữu ích cần mạch lạc, đầy đủ và trôi chảy.
Số liệu tháng 9/2026 trình các nhà lập pháp cho thấy kho dữ liệu có hơn 5.000 bộ dữ liệu và trên 2,4 tỷ token. So với 600 triệu token được công bố khi khai trương, lượng văn bản tính theo token đã tăng hơn bốn lần. Con số 7.161 mục dữ liệu và 111 đóng góp tư nhân đem lại một góc nhìn khác về cơ cấu của kho.
Vì sao ngôn ngữ địa phương quan trọng
Wu Che-yu, nghệ sĩ truyền thông mới sáng lập dự án tri thức cộng đồng Taiwan.md, cho rằng chữ Hán phồn thể chiếm tỷ trọng quá nhỏ trong dữ liệu huấn luyện AI phổ biến. Ông ước tính tỷ lệ này trong dữ liệu huấn luyện tiếng Trung dưới 1%, con số ông nêu khi giải thích về dự án của mình.
Mối quan ngại của Wu không chỉ là chuyển chữ giản thể sang chữ phồn thể. Đài Loan và Trung Quốc dùng những từ khác nhau để chỉ một số sự vật thường ngày, và cùng một cách diễn đạt có thể mang ý nghĩa khác nhau. Tri thức địa phương còn bao gồm các thể chế, lịch sử và ẩm thực, trong đó có những món ăn ít được quốc tế chú ý hơn trà sữa trân châu hay bánh bao súp.
Taiwan.md sử dụng công cụ AI để thu thập thông tin trên web và biên tập các bài viết về thiên nhiên, xã hội và lịch sử Đài Loan. 1.123 bài viết của dự án dựa trên các bài nghiên cứu học thuật, blog và thông tin chính phủ được công khai. Wu muốn các mô hình phổ biến như ChatGPT, Gemini và Claude tiếp cận nhiều hơn với những bài viết phản ánh trải nghiệm của người Đài Loan.
Chính phủ mô tả tham vọng liên quan là AI chủ quyền: phát triển các nguồn lực và năng lực AI mà Đài Loan có thể định hướng theo nhu cầu riêng. Kho ngữ liệu cung cấp tư liệu huấn luyện; các dự án như Taiwan.md tìm cách giúp nhà phát triển AI dễ dàng tìm thấy tri thức địa phương.
Khiếu nại hình sự làm thay đổi cách tính toán
Tháng 7/2025, một nghiên cứu sinh tiến sĩ Đại học Quốc gia Đài Loan đối mặt với khiếu nại hình sự về bản quyền sau khi phát tán một kho ngữ liệu chữ Hán phồn thể gồm 140.000 bài báo của Hãng Thông tấn Trung ương, chưa được cấp phép. Nghiên cứu sinh này thu thập tư liệu từ một trang web của Mỹ lưu trữ các nguồn tài nguyên mở và chia sẻ bộ sưu tập mà không thu phí.
Hai bên sau đó đã dàn xếp. Nghiên cứu sinh xin lỗi, kêu gọi các nhà nghiên cứu kiểm tra tính hợp pháp của nguồn dữ liệu và gỡ bỏ toàn bộ kho ngữ liệu.
Wu cho biết vụ việc khiến các nhà phát triển độc lập thận trọng hơn. Nhóm Taiwan.md loại bỏ tư liệu khi phát hiện nguy cơ có vấn đề về bản quyền, khiến việc mở rộng bộ sưu tập chậm lại. Với một dự án nhỏ, nguy cơ bị khởi tố hình sự khiến công việc vốn đã khó khăn là xác minh giấy phép càng kéo theo rủi ro cá nhân.
Một số mốc thời gian cho thấy vấn đề này đã phát triển như thế nào:
- Đầu năm 2023: Hội đồng Khoa học và Công nghệ Quốc gia khởi động dự án mô hình ngôn ngữ TAIDE với kinh phí hơn 200 triệu Đài tệ.
- Tháng 7/2025: Nghiên cứu sinh đối mặt với khiếu nại liên quan đến kho ngữ liệu chứa các bài báo chưa được cấp phép.
- Ngày 24/12/2025: Bộ Kỹ thuật số công bố kho ngữ liệu AI chủ quyền với 600 triệu token.
- Tháng 9/2026: Số liệu của bộ cho thấy có hơn 5.000 bộ dữ liệu và trên 2,4 tỷ token.
- Ngày 14/10/2026: Bộ trưởng Lin nói với các nhà lập pháp rằng việc đóng góp tư nhân là tự nguyện và các thỏa thuận trả phí cho nội dung là mục tiêu chính sách.
Bản quyền liên quan đến huấn luyện AI ra sao
Chen Chi-tung, luật sư cấp cao tại Công ty Luật Luguo, xác định sao chép là vấn đề pháp lý trọng tâm. Các nhà phát triển thường cần sao chép văn bản trước khi dùng để huấn luyện mô hình. Luật bản quyền trao cho chủ sở hữu quyền kiểm soát việc sao chép, nhưng có một số ngoại lệ như sử dụng hợp lý.
Sử dụng hợp lý cho phép dùng một số tác phẩm được bảo hộ mà không cần xin phép trong những trường hợp nhất định. Chen cho biết các quy định hiện hành của Đài Loan không đề cập rõ ràng đến việc huấn luyện AI, khiến nhà phát triển không chắc tòa án có chấp nhận cách sử dụng của họ hay không.
Huấn luyện và tạo câu trả lời cũng là những hành vi khác nhau. Trong quá trình huấn luyện, hệ thống xử lý các ví dụ để học các quy luật. Khi tạo câu trả lời, hệ thống tạo văn bản cho người dùng. Chen đề xuất luật cần quy định riêng hai giai đoạn, trong đó có nguy cơ đầu ra gần giống với tác phẩm được bảo hộ.
Cục Sở hữu trí tuệ thuộc Bộ Kinh tế cho biết các điều chỉnh pháp lý khả thi vẫn đang được nghiên cứu. Bộ Kỹ thuật số xác định cục này là cơ quan chịu trách nhiệm về chính sách bản quyền. Một cuộc điều tra của Viện Giám sát cũng kêu gọi chủ động điều chỉnh khuôn khổ pháp lý sau khi Hành chính viện giao nhiệm vụ này cho cục.
Cấp phép tự nguyện, không chuyển giao quyền sở hữu
Bộ trưởng Lin nói với Ủy ban Giao thông của cơ quan lập pháp rằng chương trình thu thập tư liệu tư nhân trước tiên hướng đến các nhà xuất bản và nền tảng sách điện tử. Ông mô tả bốn loại tư liệu đang được tìm kiếm:
- Sách đã hết thời hạn bảo hộ bản quyền.
- Thông tin giới thiệu sách do nhà xuất bản cung cấp.
- Một số đoạn trích xem trước được tuyển chọn từ sách.
- Tác phẩm do từng tác giả tự nguyện cấp phép.
Lin cho biết bộ xin phép sử dụng tác phẩm để huấn luyện AI, còn tác giả vẫn giữ quyền sở hữu bản quyền. Giấy phép cho phép một bên khác thực hiện những hoạt động cụ thể theo các điều kiện đã thỏa thuận. Phạm vi giấy phép có thể quy định những vấn đề như mục đích sử dụng được phép và thời hạn.
Nghị sĩ Lin Chu-yin thuộc Đảng Dân Tiến chất vấn cách trả tiền cho người đóng góp, điều gì sẽ xảy ra nếu sau này họ rút lại sự cho phép và cách bảo vệ lợi ích của họ khi hoạt động huấn luyện dẫn đến các sản phẩm khác. Nghị sĩ Hung Yu-hsiang thuộc Đảng Nhân dân Đài Loan đề xuất một dịch vụ phụ trách kiểm tra chất lượng, xác minh quyền, mua tư liệu có trả phí và quản lý các loại giấy phép khác nhau.
Bộ đã công bố Giấy phép Kho ngữ liệu huấn luyện AI chủ quyền Đài Loan, phiên bản 1, và phối hợp với Cục Sở hữu trí tuệ xây dựng các ví dụ nhằm hỗ trợ cơ quan nhà nước áp dụng. Các điều khoản tiêu chuẩn hướng đến giảm bớt việc đàm phán lặp đi lặp lại và tranh chấp bản quyền. Bộ cũng đang lên kế hoạch khuyến khích đóng góp. Tỷ lệ thanh toán, thỏa thuận rút lại quyền cho phép và quy định đối với các sản phẩm phát sinh vẫn chưa được thống nhất trong những đề xuất công khai.
Hợp tác có trả phí đã có một tiền lệ nhỏ
Lee Po-feng, chủ tịch Quỹ Văn hóa Mở, cho rằng khó có thể thu hút đủ người tham gia nếu yêu cầu nhà xuất bản cung cấp miễn phí tư liệu có giá trị. Ông dẫn ví dụ một dự án huấn luyện nhỏ đã đạt được thỏa thuận với các nền tảng truyền thông và giáo dục thông qua trao đổi có thương lượng.
Thỏa thuận bao gồm một khoản thanh toán cấp phép duy nhất, giới hạn thời gian sử dụng dữ liệu trong hai năm và quyền tiếp cận ưu tiên mô hình tạo ra sau đó dành cho các nhà cung cấp nội dung tham gia. Cơ chế này đem lại cho bên đóng góp tiền, thời hạn sử dụng rõ ràng và một lợi ích thiết thực.
Wang Rong-wen, chủ tịch Nhà xuất bản Yuan-Liou, cũng cho rằng các nhà phát triển của chính phủ và doanh nghiệp nên dành ngân sách cho giấy phép nội dung. Ông nhận định nỗi lo bị khiếu nại hình sự đang hạn chế cả các nhà phát triển tư nhân lẫn quan chức tìm cách hỗ trợ các dự án AI.
Lin nói với các nhà lập pháp rằng mục tiêu cuối cùng của chính phủ là thu phí các công ty AI lớn để họ tiếp cận nội dung. Ông cho biết tranh chấp bản quyền liên quan đến công nghệ mới có thể kéo dài từ ba đến năm năm, nên bộ bắt đầu với những tư liệu ít gây tranh chấp hơn. Mốc thời gian ông nêu là thời gian tranh cãi có thể kéo dài, chứ không phải hạn chót ban hành luật hay xây dựng cơ chế thanh toán.
Ngoại lệ pháp lý và giấy phép tập thể là hai phương án cạnh tranh
Chen đề xuất bổ sung một chương riêng về AI vào Luật Bản quyền Đài Loan. Chương này sẽ quy định ngoại lệ cho hoạt động khai thác văn bản và dữ liệu, yêu cầu công khai nguồn huấn luyện và giảm nguy cơ bị xử lý hình sự đối với hoạt động đáp ứng điều kiện.
Khai thác văn bản và dữ liệu là việc dùng phần mềm phân tích lượng lớn tư liệu để nhận diện quy luật. Liên minh châu Âu, Nhật Bản và Singapore có các ngoại lệ cho một số hình thức hoạt động này, dù quy định và điều kiện giữa các nơi khác nhau. Chen xem những cách tiếp cận đó là hình mẫu để Đài Loan thảo luận.
Lee đề xuất một bước hành chính sớm hơn: ban hành hướng dẫn giải thích những hình thức sử dụng để huấn luyện nào được cơ quan chức năng xem là sử dụng hợp lý và những hình thức nào có nguy cơ xâm phạm bản quyền. Ông dẫn ví dụ danh sách kiểm tra và hướng dẫn về bản quyền AI năm 2024 của Cơ quan Văn hóa Nhật Bản, giúp các nhà phát triển và nhà sáng tạo hiểu rõ hơn những yêu cầu trong thực tế.
Chen cũng đề xuất cấp phép tập thể, dựa trên mô hình của Hiệp hội Bản quyền Âm nhạc Trung Hoa Đài Bắc, gọi tắt là MÜST, trong lĩnh vực âm nhạc. Theo mô hình này, một tổ chức quản lý giấy phép cho nhiều chủ sở hữu quyền, thu phí và phân phối tiền thanh toán. Với AI, một dịch vụ tương tự có thể giảm bớt công sức phải đàm phán riêng với hàng trăm nhà xuất bản hoặc tác giả.
Chang Chung-hsin, phó giáo sư thỉnh giảng tại Viện Sở hữu trí tuệ thuộc Đại học Khoa học và Công nghệ Quốc gia Đài Bắc, có quan điểm khác. Ông cho rằng nhà phát triển nên trả tiền theo các quy định bản quyền hiện hành thay vì tìm cách sửa luật. Quan điểm của ông đặt việc thương lượng để tiếp cận nội dung xuất bản và tin tức có giá trị vào vị trí trọng tâm của giải pháp.
TAIDE cho thấy cả quyền tiếp cận lẫn nguồn lực đều quan trọng
Dự án Bộ máy Đối thoại AI Đáng tin cậy Đài Loan trước đây, gọi tắt là TAIDE, cho thấy một mô hình có thể phụ thuộc nhiều đến mức nào vào một vài bộ dữ liệu dễ tiếp cận. Được thành lập như một dự án của Hội đồng Khoa học và Công nghệ Quốc gia vào đầu năm 2023, dự án nhận hơn 200 triệu Đài tệ cho giai đoạn phát triển ban đầu.
TAIDE sử dụng tư liệu huấn luyện từ 15 cơ quan chính phủ. Khoảng bốn triệu bài báo của Hãng Thông tấn Trung ương chiếm 70% dữ liệu văn bản. Tư liệu được lấy có cân nhắc các vấn đề bản quyền, cho thấy việc tiếp cận có tổ chức với những kho lưu trữ tin tức lớn có thể hỗ trợ một mô hình trong nước.
Điều tra viên chính Yuh-Jye Lee, thuộc Trung tâm An ninh thông tin Đài Loan tại Academia Sinica, giải thích giá trị của việc có một lựa chọn trong nước:
Ban đầu có lẽ chúng ta chưa thể sánh với các mô hình lớn, nhưng việc có bộ máy đối thoại riêng đồng nghĩa ít nhất chúng ta có một lựa chọn.
Mô hình ban đầu được xây dựng trên Llama 2 của Meta và có bảy tỷ tham số, tức các giá trị số mà mô hình điều chỉnh trong quá trình học. Trung tâm Tính toán Hiệu năng cao Quốc gia có 1.028 bộ xử lý đồ họa V100 và mua chín bộ xử lý H100 vào tháng 11/2023 cho dự án, đồng thời vẫn duy trì các dịch vụ thường xuyên.
Dự án hỏi đáp về nông nghiệp Demeter GPT của Đại học Quốc gia Trung Hưng sau đó chuyển từ ChatGPT sang TAIDE. Phó giáo sư Fan Yao-chung cho biết độ chính xác tiếng Trung được cải thiện sau khi huấn luyện bổ sung. Trước đó, phòng thí nghiệm trả OpenAI từ 1 đến 2 Đài tệ cho mỗi câu trả lời; khi chạy TAIDE tại chỗ, chi phí vận hành chuyển sang máy tính và điện của chính phòng thí nghiệm.
Sáng kiến kho ngữ liệu của Đài Loan giải quyết nguồn cung văn bản làm nền tảng cho những ứng dụng như vậy. Từ điển và tư liệu văn hóa của chính phủ tạo nên nền móng. Việc mở rộng quyền tiếp cận sách báo, tài liệu giảng dạy chuyên môn và báo chí sẽ phụ thuộc vào những thỏa thuận mà nhà phát triển có thể chi trả và chủ sở hữu nội dung sẵn lòng chấp nhận.
Điểm chính
- Những người đóng góp tư nhân cung cấp 111 trong số 7.161 mục dữ liệu của kho ngữ liệu, tương đương khoảng 1,6%.
- Chính phủ công bố kho dữ liệu có 600 triệu token khi khai trương vào tháng 12/2025; đến tháng 9/2026, tổng số đã vượt 2,4 tỷ.
- Bộ trưởng Lin cho biết việc tham gia của khối tư nhân là tự nguyện và tác giả vẫn giữ quyền sở hữu bản quyền.
- Nội dung tin tức không thuộc chương trình thu thập tư liệu tư nhân hiện tại, trong khi bộ đang tìm kiếm các thỏa thuận có trả phí với công ty AI.
- Khiếu nại hình sự hồi tháng 7/2025 liên quan đến 140.000 bài báo chưa được cấp phép làm gia tăng lo ngại trong giới phát triển độc lập.
- Các đề xuất gồm hướng dẫn rõ ràng hơn về sử dụng hợp lý, ngoại lệ cho hoạt động khai thác dữ liệu, cấp phép tập thể và thanh toán trực tiếp theo luật hiện hành.