Mô hình học các chữ cái RNA và cách chúng liên kết
Các nhà nghiên cứu tại Đại học Khoa học và Công nghệ Trung Quốc đã công bố structRFM, một mô hình nền tảng mở về RNA được huấn luyện trên 21 triệu cặp trình tự RNA và cấu trúc được chú giải bằng phương pháp tính toán. Bản phát hành bao gồm dữ liệu huấn luyện theo cặp, trọng số mô hình và mã nguồn, cung cấp cho các phòng thí nghiệm khác tài liệu để tái tạo nghiên cứu và điều chỉnh hệ thống.
Nội dung
- Mô hình học các chữ cái RNA và cách chúng liên kết
- Vì sao cấu trúc gấp cuộn quan trọng không kém trình tự
- Cách xây dựng 21 triệu cặp dữ liệu huấn luyện
- Huấn luyện mô hình bằng thông tin bị ẩn
- Kết quả đánh giá cấu trúc
- Từ xử lý RNA đến phân loại chức năng
- Bản phát hành mở cung cấp gì cho giới nghiên cứu
- Nhóm nghiên cứu và thời điểm công bố
- Kết quả thay đổi nghiên cứu RNA ra sao
- Điểm chính
Nghiên cứu được Nature công bố ngày 4 tháng 11 năm 2026, mô tả một mô hình học cả thứ tự các thành phần phân tử của RNA lẫn những liên kết giúp các phân tử này gấp cuộn. Phiên bản được điều chỉnh để dự đoán cấu trúc ba chiều, có tên Zfold, đạt hiệu quả mà các tác giả mô tả là tương đương AlphaFold3 trong các đánh giá CASP15-natural, CASP16 và RNA-Puzzles.
Điểm hấp dẫn trong thực tế là sau khi huấn luyện, structRFM chỉ cần đầu vào là trình tự RNA. Mô hình tạo ra thông tin mà các nhà nghiên cứu có thể sử dụng cho nhiều nhiệm vụ, bao gồm dự đoán cấu trúc phân tử, xác định các vị trí tham gia vào quá trình xử lý RNA và phân loại phân tử RNA theo chức năng.
Bài báo nghiên cứu về structRFM trên Nature trình bày công trình như một cách giúp vận dụng kiến thức cấu trúc vào nhiều nhiệm vụ dự đoán khác nhau. Peng Xiong và S. Kevin Zhou là các tác giả liên hệ, còn Heqin Zhu là tác giả thứ nhất.
Vì sao cấu trúc gấp cuộn quan trọng không kém trình tự
RNA tham gia vào quá trình sản xuất protein, điều hòa gene và xử lý các thông tin di truyền. Trình tự của RNA là thứ tự các nucleotide, những đơn vị phân tử thường được biểu thị bằng các chữ cái A, U, C và G. Thứ tự này mang thông tin, còn cách phân tử gấp cuộn góp phần quyết định chức năng của nó.
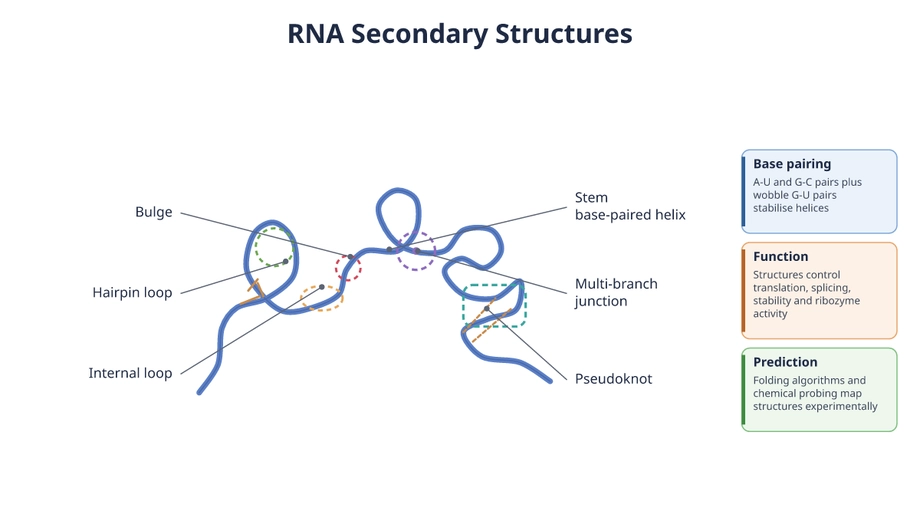
Các phần của một sợi RNA có thể bắt cặp với những phần khác trên cùng sợi. Những liên kết này tạo nên cấu trúc bậc hai, một kiểu sắp xếp gồm các vùng bắt cặp, thân và vòng. Sau đó, phân tử gấp thành hình dạng ba chiều, gọi là cấu trúc bậc ba, ảnh hưởng đến hoạt tính và tương tác của nó với các phân tử khác.
Nhiều mô hình ngôn ngữ RNA học các kiểu mẫu từ những tập hợp trình tự lớn, tương tự cách mô hình ngôn ngữ học mối liên hệ giữa các từ. structRFM bổ sung thông tin về các nucleotide bắt cặp với nhau trong quá trình huấn luyện, giúp mô hình học được mối liên hệ giữa những vị trí có thể cách xa nhau trên trình tự.
Các nhà nghiên cứu muốn giữ được tính linh hoạt của mô hình nền tảng: một hệ thống được huấn luyện trên phạm vi rộng, có thể điều chỉnh các đặc trưng đã học cho nhiều mục đích khác nhau. Mục tiêu của họ là đưa thông tin về quá trình gấp cuộn vào nền tảng dùng chung đó, thay vì huấn luyện một hệ thống chỉ hữu ích cho một nhiệm vụ cấu trúc duy nhất.
Cách xây dựng 21 triệu cặp dữ liệu huấn luyện
Nhóm nghiên cứu xây dựng một tập dữ liệu gồm khoảng 21 triệu cặp trình tự RNA và cấu trúc bậc hai. Các chú giải cấu trúc được tạo bằng phương pháp tính toán, giúp nhóm huấn luyện ở quy mô lớn hơn nhiều so với tập dữ liệu chỉ gồm các cấu trúc được xác định qua thí nghiệm trong phòng thí nghiệm.
Dự đoán bằng máy tính có thể chứa sai sót và phản ánh cả điểm mạnh lẫn điểm yếu của phương pháp tạo ra chúng. Để giảm sự phụ thuộc vào một công cụ dự đoán duy nhất, các nhà nghiên cứu đưa ra MUSES, một phương pháp tổ hợp cấu trúc bậc hai từ nhiều nguồn. Phương pháp tổ hợp kết hợp thông tin từ nhiều nguồn dự đoán thay vì hoàn toàn dựa vào một nguồn.
MUSES giải quyết một vấn đề cốt lõi khi dạy mô hình bằng cấu trúc dự đoán: các sai sót lặp lại trong chú giải huấn luyện có thể định hình những gì mô hình học được. Việc kết hợp các dự đoán cấu trúc được thiết kế nhằm giảm thiên lệch của công cụ dự đoán trong khi vẫn giữ lại thông tin hữu ích về bắt cặp base.
Nguồn dữ liệu huấn luyện và đánh giá của nghiên cứu lấy từ các bộ dữ liệu sinh học đã được thiết lập, bao gồm RNAcentral, Rfam và Protein Data Bank. Tuyên bố về dữ liệu của nghiên cứu nêu rõ các phiên bản được sử dụng, trong đó có RNAcentral phiên bản 24.0 và Rfam phiên bản 14.10 và 15.0, giúp các nhà nghiên cứu truy xuất những tập dữ liệu dùng trong thí nghiệm.
Huấn luyện mô hình bằng thông tin bị ẩn
structRFM sử dụng mô hình hóa ngôn ngữ với các phần bị che, một phương pháp huấn luyện trong đó một số phần đầu vào được ẩn đi và mô hình học cách khôi phục thông tin còn thiếu dựa trên ngữ cảnh xung quanh. Với RNA, điều này có nghĩa là học mối liên hệ giữa các nucleotide thay vì giữa các từ.
Nhóm nghiên cứu lồng ghép thông tin bắt cặp base vào quy trình này thông qua một thao tác ghép cặp. Tỷ lệ che động giúp cân bằng giữa huấn luyện dựa trên các liên kết cấu trúc và việc che từng vị trí nucleotide. Nhờ đó, mô hình có cơ hội học cả các kiểu mẫu trình tự cục bộ lẫn những mối liên hệ gắn với quá trình gấp cuộn.
Mô hình tạo ra ba dạng đặc trưng: thông tin về toàn bộ trình tự, thông tin về từng nucleotide và thông tin về các cặp nucleotide. Đặc trưng là một biểu diễn dạng số mà hệ thống dự đoán khác có thể sử dụng. Tùy từng nhiệm vụ, có thể khai thác những cấp độ biểu diễn khác nhau.
Các nhà nghiên cứu cũng thực hiện thí nghiệm loại bỏ thành phần, trong đó họ loại bỏ hoặc thay đổi một phần mô hình để kiểm tra mức độ đóng góp của phần đó. Kết quả ủng hộ vai trò của cả thông tin cấu trúc lẫn chiến lược che trong những cải thiện được báo cáo, cung cấp bằng chứng cho các lựa chọn thiết kế của structRFM.
Kết quả đánh giá cấu trúc
structRFM đạt kết quả tốt trong phân loại tương đồng không cần huấn luyện riêng cho nhiệm vụ. Tính tương đồng đề cập đến mối quan hệ được di truyền từ một nguồn gốc tiến hóa chung. Trong trường hợp này, phân loại không cần huấn luyện riêng kiểm tra mức độ hữu ích của các biểu diễn đã học trong việc nhận diện những mối quan hệ đó mà không huấn luyện riêng trên nhiệm vụ phân loại mục tiêu.
Các tác giả cũng báo cáo khả năng dự đoán cấu trúc bậc hai được cải thiện và hiệu quả cao trên các họ RNA mới được công bố. Một họ RNA gồm các phân tử có liên quan với nhau và có chung đặc điểm trình tự hoặc cấu trúc. Việc thử nghiệm trên các họ mới được công bố giúp đánh giá khả năng hoạt động của mô hình ngoài những nhóm quen thuộc trong các tập dữ liệu đã được thiết lập.
Để dự đoán cấu trúc bậc ba, nhóm nghiên cứu phát triển Zfold bằng cách điều chỉnh các đặc trưng đã học của structRFM cho một mô hình dự đoán hình dạng ba chiều. Các tác giả báo cáo cải thiện cả về hình dạng dự đoán lẫn cấu trúc bậc hai được suy ra từ những dự đoán đó.
Zfold được đánh giá trên CASP15-natural, CASP16 và RNA-Puzzles, các bộ chuẩn dùng để đánh giá khả năng dự đoán cấu trúc phân tử. Trong các đánh giá này, bài báo mô tả hiệu quả của mô hình là tương đương AlphaFold3. Phép so sánh áp dụng cho kết quả của Zfold trên các bộ chuẩn nêu trên, còn structRFM cung cấp các biểu diễn RNA nền tảng.
Nghiên cứu ghi nhận nhiều dạng thành công khác nhau, chứ không chỉ một điểm chính xác duy nhất đại diện cho mọi ứng dụng. Nhận diện trình tự có liên quan, dự đoán cặp base và tái dựng hình dạng ba chiều là những bài toán khác nhau, mỗi bài toán cần được đánh giá riêng.
Từ xử lý RNA đến phân loại chức năng
structRFM cũng được thử nghiệm với các nhiệm vụ liên quan đến chức năng của RNA. Những nhiệm vụ này bao gồm dự đoán vị trí nối, nhận diện vị trí đi vào ribosome nội tại và phân loại RNA không mã hóa, mở rộng phạm vi đánh giá vượt ra ngoài hình dạng phân tử.
Các vị trí nối đánh dấu ranh giới được sử dụng khi tế bào xử lý các thông điệp RNA. Trong quá trình nối, một số đoạn được loại bỏ và các đoạn còn lại được ghép với nhau. Dự đoán những ranh giới này giúp các nhà nghiên cứu tìm hiểu cách một thông điệp di truyền được lắp ráp trước khi dùng để tạo protein.
Các vị trí đi vào ribosome nội tại, hay yếu tố IRES, là những vùng RNA cho phép bộ máy tế bào chịu trách nhiệm tạo protein bắt đầu quá trình dịch mã từ bên trong. Việc nhận diện các vị trí này đòi hỏi phát hiện những kiểu mẫu chức năng trong trình tự, qua đó tạo thêm một phép thử về lượng thông tin được nắm bắt trong quá trình tiền huấn luyện.
RNA không mã hóa đảm nhiệm những vai trò khác ngoài việc làm khuôn để sản xuất protein. Phân loại chúng có nghĩa là xếp các phân tử vào những nhóm phù hợp. Các tác giả báo cáo hiệu quả được cải thiện trên những nhiệm vụ chức năng này, cho thấy các biểu diễn đã học vẫn hữu ích khi mục tiêu dự đoán chuyển từ cấu trúc sang vai trò sinh học.
Nhóm nghiên cứu cũng mở rộng mô hình sang nhiệm vụ phân loại RNA không mã hóa dài bằng chiến lược phân đoạn. Chia trình tự dài thành các phần giúp có thể áp dụng mô hình cho những đầu vào vốn khó xử lý như một đơn vị duy nhất.
Bản phát hành mở cung cấp gì cho giới nghiên cứu
Bản phát hành gồm ba nguồn tài nguyên với các mục đích khác nhau. Tập dữ liệu cung cấp những ví dụ được dùng để huấn luyện. Trọng số mô hình chứa các giá trị số được học trong quá trình huấn luyện. Mã nguồn mô tả cách triển khai và vận hành phần mềm.
Truy cập vào trọng số cho phép các nhà nghiên cứu sử dụng một mô hình đã được huấn luyện thay vì phải lặp lại toàn bộ quá trình tiền huấn luyện. Truy cập dữ liệu và mã nguồn hỗ trợ việc xem xét kỹ hơn quy trình huấn luyện, tái tạo thí nghiệm và phát triển các phương pháp thay thế.
Bài báo nêu kho mã nguồn của dự án trên GitHub là heqin-zhu/structRFM. Bài báo cũng liệt kê kho lưu trữ Zenodo cho tập dữ liệu tiền huấn luyện với DOI 10.5281/zenodo.18272040 và kho lưu trữ mã nguồn cùng các điểm kiểm tra mô hình với DOI 10.5281/zenodo.18274292. DOI là mã định danh bền vững, nhằm giúp truy xuất tài nguyên nghiên cứu theo thời gian.
Tuyên bố về dữ liệu cho biết các tập dữ liệu huấn luyện và kiểm tra được công khai thông qua kho mã nguồn của dự án. Tài liệu cũng cung cấp phần chia IRES đã qua xử lý được sử dụng trong nghiên cứu và dữ liệu nguồn làm cơ sở cho các hình minh họa. Các tác giả cho biết không có hạn chế nào đối với việc tiếp cận dữ liệu.
Những chi tiết này rất quan trọng khi so sánh. Các nhà nghiên cứu có thể kiểm tra tập dữ liệu và cách phân chia được sử dụng, chạy lại các đánh giá và thử xem một lựa chọn huấn luyện khác có làm thay đổi kết quả hay không. Vì vậy, bản phát hành hỗ trợ việc kiểm chứng kết quả cũng như tái sử dụng mô hình.
Nhóm nghiên cứu và thời điểm công bố
Công trình được thực hiện tại Trường Kỹ thuật Y sinh thuộc USTC và phòng thí nghiệm Hình ảnh Y khoa, Robotics, Điện toán Phân tích và Học máy, gọi tắt là MIRACLE. Các tác giả nêu cơ quan công tác tại Hợp Phì và Viện Nghiên cứu Cao cấp Tô Châu của USTC. Đồng tác giả Ruifeng Li công tác tại Trường Khoa học và Công nghệ Máy tính thuộc Đại học Chiết Giang ở Hàng Châu.
Zhou, giáo sư, và Xiong, nghiên cứu viên đặc biệt, đề xuất và giám sát nghiên cứu. Zhu thiết kế và triển khai khuôn khổ, tiến hành tiền huấn luyện cùng một số thí nghiệm dự đoán cấu trúc và phân loại RNA, đồng thời phân tích kết quả. Các thành viên khác trong nhóm thực hiện kiểm tra tính tương đồng, so sánh tập dữ liệu, nhận diện IRES và đánh giá cấu trúc.
Nghiên cứu được công bố và giới thiệu rộng rãi vào hai ngày lịch khác nhau:
- Ngày 4 tháng 11 năm 2026: Nature ghi nhận công bố bài báo An open structure-guided RNA foundation model for generalizable prediction.
- Ngày 5 tháng 11 năm 2026: Công trình và bản phát hành mở được giới thiệu tại Trung Quốc; bài báo trực tuyến được cho biết đăng vào sáng sớm.
Các tác giả cho biết nghiên cứu nhận được hỗ trợ từ Quỹ Khoa học Tự nhiên Quốc gia Trung Quốc, Chương trình Nghiên cứu và Phát triển Trọng điểm Quốc gia, các chương trình nghiên cứu tại Giang Tô và Tô Châu, cùng Dự án Sanming về Y học tại Thâm Quyến. Họ tuyên bố không có lợi ích cạnh tranh.
Kết quả thay đổi nghiên cứu RNA ra sao
structRFM tạo ra một điểm khởi đầu chung cho nhiều hoạt động nghiên cứu. Một phòng thí nghiệm nghiên cứu quá trình xử lý RNA có thể điều chỉnh cùng mô hình nền tảng mà một nhóm khác sử dụng để nghiên cứu quá trình gấp cuộn hoặc phân loại phân tử không mã hóa. Mỗi ứng dụng vẫn cần được phát triển và đánh giá riêng cho từng nhiệm vụ.
Sự kết hợp giữa 21 triệu cặp dữ liệu huấn luyện, phương pháp học có định hướng cấu trúc và các điểm kiểm tra được công bố giúp các nhà nghiên cứu có một hệ thống cụ thể để xem xét, thay vì chỉ có mô tả về một thuật toán. MUSES và các thí nghiệm che cũng đưa ra những lựa chọn thiết kế cụ thể để các nhóm khác kiểm tra hoặc điều chỉnh.
Các kết quả được báo cáo tập trung vào dự đoán và phân loại bằng phương pháp tính toán. Để hướng tới ứng dụng y sinh, cần tiến hành thêm các thí nghiệm sinh học, bao gồm kiểm tra cấu trúc dự đoán và xác minh chức năng được gán cho những phân tử RNA cụ thể.
Bài báo không đưa ra thời gian dự kiến cho một ứng dụng lâm sàng. Thay đổi trước mắt là khả năng tiếp cận: các nhà nghiên cứu trên toàn thế giới có thể nhận được tài nguyên huấn luyện, kiểm tra cách triển khai và tìm hiểu xem những cải thiện được báo cáo có áp dụng được cho tập dữ liệu RNA của họ hay không.
Điểm chính
- Các nhà nghiên cứu USTC công bố structRFM, một mô hình nền tảng RNA được huấn luyện trên khoảng 21 triệu cặp trình tự và cấu trúc bậc hai.
- Mô hình học các kiểu mẫu trình tự và mối liên hệ bắt cặp base, sau đó tạo đặc trưng chỉ từ đầu vào là trình tự.
- MUSES kết hợp nhiều nguồn dự đoán cấu trúc, còn cơ chế che động cân bằng thông tin cấu trúc và nucleotide trong quá trình huấn luyện.
- Các tác giả báo cáo khả năng phân loại tương đồng tốt và dự đoán cấu trúc bậc hai được cải thiện, bao gồm thử nghiệm trên các họ RNA mới được công bố.
- Zfold, phiên bản được điều chỉnh để dự đoán cấu trúc bậc ba, đạt hiệu quả được mô tả là tương đương AlphaFold3 trên ba bộ chuẩn được nêu tên.
- Tập dữ liệu, trọng số mô hình, mã nguồn và tài nguyên đánh giá được công khai để tái sử dụng và tái tạo nghiên cứu.