GPU hoạt động thực tế và tuyên bố thông lượng cao hơn 5%
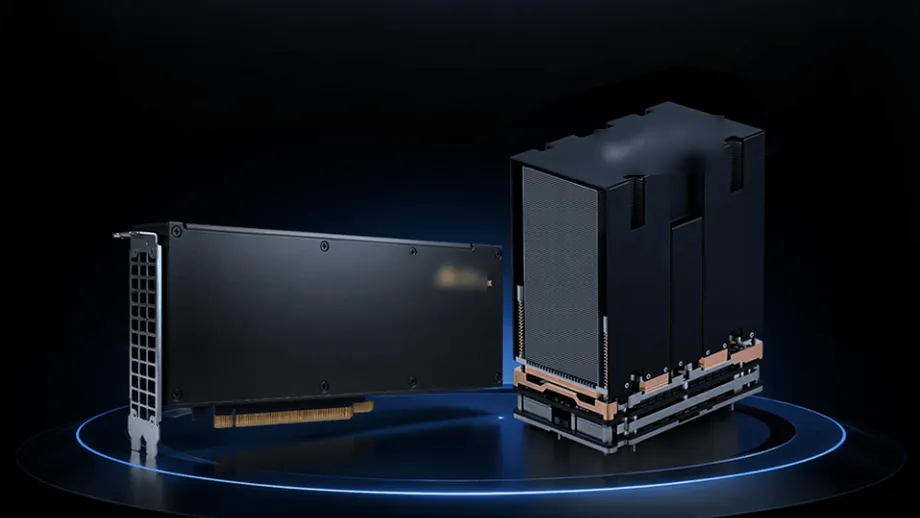
Iluvatar CoreX đã công khai trình diễn bộ xử lý đồ họa Tiangai 300 tại Thượng Hải, giới thiệu sản phẩm như một lựa chọn thay thế của Trung Quốc cho Nvidia H200, với tuyên bố đạt lợi thế 5% trong một bài kiểm tra suy luận của bên thứ ba. Tại ngày mở cửa cho truyền thông hôm 28 tháng 10 năm 2026, công ty cũng trình diễn hệ thống huấn luyện gồm tám GPU và giới thiệu một tủ máy chủ chứa 144 GPU cùng 18 CPU.
Nội dung
- GPU hoạt động thực tế và tuyên bố thông lượng cao hơn 5%
- Phép so sánh với H200 đo lường điều gì
- Xử lý tài liệu dài và phản hồi ban đầu nhanh hơn
- Kết quả huấn luyện dùng một GPU Nvidia khác làm mốc
- Từ ra mắt hồi tháng 7 đến màn trình diễn tháng 10
- Tủ máy chủ được thiết kế quanh 144 GPU
- Phân chia công việc AI giữa các chip khác nhau
- Tuyên bố về phần mềm tập trung vào thời gian triển khai
- TY1200 mở rộng hướng tiếp cận sang robot
- Điểm chính
Theo Iluvatar CoreX, so sánh nổi bật này dựa trên thử nghiệm do Tập đoàn Điện lực Thượng Hải hoàn tất hồi tháng 7. Trong cấu hình triển khai tách biệt hai giai đoạn xử lý mô hình ngôn ngữ lớn, Tiangai 300 đạt thông lượng tổng thể tương đương 1,05 lần H200 sau khi kết quả được quy đổi theo từng card.
Thông lượng cho biết lượng công việc hữu ích mà hệ thống hoàn thành trong một khoảng thời gian nhất định. Với chatbot, chỉ số này có thể là số đoạn văn bản được tạo ra mỗi giây. Kết quả bằng 1,05 lần hiệu năng tham chiếu nghĩa là hệ thống tạo ra nhiều hơn 5% đầu ra trong các điều kiện thử nghiệm đó.
Công ty mô tả Tiangai 300 là GPU đa dụng đầu tiên của Trung Quốc đạt hiệu năng H200 trong các thử nghiệm đo lường. Màn trình diễn hồi tháng 10 mở rộng so sánh sang mô hình ngôn ngữ, tạo ảnh và tạo video, trong khi một buổi trình diễn huấn luyện riêng dùng Nvidia H100 làm mốc tham chiếu.
Sự kiện không chỉ giới thiệu thông số chip. Iluvatar CoreX trưng bày card, máy chủ, thiết kế tủ máy chủ mật độ cao, công cụ phần mềm và phương thức phân chia công việc AI giữa các loại bộ xử lý khác nhau. Luận điểm thương mại của công ty là những thành phần này có thể tạo ra đầu ra AI hữu ích với chi phí thấp hơn và thời gian chờ ngắn hơn.
Phép so sánh với H200 đo lường điều gì
Bài thử nghiệm hồi tháng 7 của Tập đoàn Điện lực Thượng Hải sử dụng phương pháp tách biệt prefill và decode, thường gọi tắt là PD. Prefill là giai đoạn mô hình ngôn ngữ đọc yêu cầu của người dùng và tài liệu hỗ trợ. Decode là giai đoạn mô hình tạo câu trả lời, từng token một. Token là những đơn vị nhỏ mà các hệ thống AI dùng để chia văn bản.
Tách riêng hai giai đoạn này cho phép hệ thống phân bổ tài nguyên khác nhau cho việc đọc và viết. Vì vậy, kết quả của Tiangai 300 áp dụng cho một cách triển khai cụ thể, với hiệu năng tổng thể được quy đổi thành mức tương đương trên một card.
Iluvatar CoreX chưa công bố phương pháp thử nghiệm chi tiết, danh sách mô hình hay điều kiện khối lượng công việc làm cơ sở cho kết quả nổi bật từ bên thứ ba. Các chi tiết đó, cùng cách tính quy đổi và thiết lập phần mềm, là cần thiết để có thể tái lập độc lập. So sánh chi phí cũng chưa có bảng phân tích được công bố, trong khi cần làm rõ dung lượng bộ nhớ của từng card và toàn bộ tủ máy chủ.
Các buổi trình diễn được phòng thí nghiệm của công ty nêu tên cho thấy cụ thể hơn những tuyên bố này. Kết quả cho thấy mức cải thiện khác nhau tùy tác vụ, từ mức tăng nhỏ trong tạo nội dung đa phương thức đến mức tăng lớn hơn về thông lượng hệ thống gợi ý. Với người mua, phép so sánh phù hợp nhất là tác vụ mà dịch vụ của họ thực sự chạy.
Xử lý tài liệu dài và phản hồi ban đầu nhanh hơn
Theo phòng thí nghiệm của công ty, hiệu năng attention của Tiangai 300 đạt 1,05 lần H200 ở độ dài ngữ cảnh 64K. Attention là quá trình giúp mô hình xác định những phần nào trong dữ liệu đầu vào có liên quan với nhau. Độ dài ngữ cảnh 64K nghĩa là mô hình xử lý khoảng 64.000 token.
Với GLM-5.3 ở cùng quy mô ngữ cảnh, Iluvatar CoreX tuyên bố thông lượng đạt 1,15 lần H200 trong khi vẫn duy trì trải nghiệm người dùng tương đương. Đó là mức tăng 15% đối với khối lượng công việc mô hình hỗn hợp chuyên gia được thử nghiệm. Mô hình hỗn hợp chuyên gia phân phối tác vụ cho các mạng chuyên biệt được lựa chọn, thay vì dùng mọi mạng cho từng token.
Với các tác vụ tác nhân AI có ngữ cảnh từ 8K đến 128K, công ty cho biết thời gian chờ token đầu tiên giảm khoảng 10% đến 30%. Chỉ số này quan trọng với người đang chờ trợ lý bắt đầu trả lời sau khi đọc tài liệu dài hoặc xử lý yêu cầu phức tạp.
Tạo ảnh và video cũng là một phần của màn trình diễn. Công ty cho biết thông lượng tạo nội dung đa phương thức tăng khoảng 2% đến 5% so với H200. Với các tác vụ tìm kiếm trực tuyến, quảng cáo và gợi ý, công ty tuyên bố thông lượng suy luận gợi ý cao hơn 21% và độ trễ tính toán nhẹ thấp hơn 26%.
Kết quả huấn luyện dùng một GPU Nvidia khác làm mốc
Màn trình diễn huấn luyện sử dụng Qwen3-32B, mô hình có khoảng 32 tỷ tham số, trên máy chủ tám GPU. Tham số là các giá trị số mà mô hình điều chỉnh trong quá trình huấn luyện để học các quy luật. Iluvatar CoreX cho biết thông lượng hiệu dụng trên mỗi card đạt 1,33 lần Nvidia H100.
Do đó, lợi thế được báo cáo trong màn trình diễn huấn luyện này là 33%, với H100 làm chip đối chiếu. Các kết quả suy luận khác tại sự kiện dùng H200. Cần phân biệt rõ các sản phẩm tham chiếu này để hiểu đúng các con số.
Hệ thống huấn luyện hoạt động ở độ chính xác FP8. FP8 lưu trữ số bằng tám bit, giảm lượng dữ liệu cần di chuyển và xử lý so với các định dạng dùng nhiều bit hơn. Phần mềm huấn luyện AI phải quản lý cẩn thận mức chính xác thấp hơn này để duy trì chất lượng học.
Iluvatar CoreX cũng cho biết độ biến thiên thời gian mỗi bước là 0,43% trong quá trình hoạt động kéo dài ở tải tối đa, so với 0,76% ở hệ thống tham chiếu dùng kiến trúc Hopper. Thời gian mỗi bước là khoảng thời gian cần để hoàn thành một đơn vị công việc lặp lại. Thời gian ổn định hơn có thể giúp đơn vị vận hành dự tính khối lượng công việc mà hệ thống bận rộn sẽ hoàn thành.
Từ ra mắt hồi tháng 7 đến màn trình diễn tháng 10
Tiangai 300 được chính thức giới thiệu tại Hội nghị Trí tuệ Nhân tạo Thế giới vào tháng 7 năm 2026. Sản phẩm sử dụng kiến trúc Tianshu của công ty, tích hợp thế hệ Tensor Core mới và có dung lượng bộ nhớ đồ họa được công bố là 144GB.
Bộ xử lý hỗ trợ các phép toán vô hướng, vector và tensor. Nói đơn giản, chúng xử lý các số riêng lẻ, nhóm số và mảng toán học lớn hơn. Các định dạng số được hỗ trợ gồm FP4, FP8, FP16 và BF16, cho phép nhà phát triển phần mềm lựa chọn giữa tốc độ, mức sử dụng bộ nhớ và độ chính xác số.
Các mốc công khai mà công ty nêu trải dài trong vài tháng:
- Tháng 7 năm 2026: Tiangai 300 ra mắt tại Hội nghị Trí tuệ Nhân tạo Thế giới.
- Tháng 7 năm 2026: Tập đoàn Điện lực Thượng Hải hoàn tất thử nghiệm bên thứ ba được viện dẫn trong phép so sánh thông lượng với H200.
- Trước sự kiện dành cho truyền thông tháng 10: thiết kế tủ máy chủ IXL144 được giới thiệu tại Hội chợ Công nghiệp Quốc tế Trung Quốc.
- Ngày 28 tháng 10 năm 2026: Iluvatar CoreX mở cửa cho truyền thông xem các màn trình diễn trực tiếp phần cứng Tiangai 300 tại Thượng Hải.
Sự kiện tháng 10 đưa câu chuyện sản phẩm từ các bài giới thiệu kiến trúc sang những hệ thống chạy các khối lượng công việc cụ thể. Theo mô tả của công ty, phạm vi triển khai hiện trải từ card tăng tốc riêng lẻ đến máy chủ tám card và hệ thống IXL144 quy mô lớn hơn.
Tủ máy chủ được thiết kế quanh 144 GPU
Theo Iluvatar CoreX, IXL144 tích hợp 144 GPU và 18 CPU trong một tủ máy chủ tiêu chuẩn, với tổng bộ nhớ GPU khoảng 10,1TB. Công ty mô tả đây là siêu nút GPU có mật độ cao nhất ngành được đặt trong một tủ máy chủ duy nhất. Siêu nút kết nối nhiều bộ xử lý ở khoảng cách gần để chúng có thể phối hợp xử lý các tác vụ lớn.
Thông số 144GB cho mỗi Tiangai 300 và tổng dung lượng 10,1TB của tủ máy chủ cần được làm rõ hơn về cấu hình. Nhân 144 card với 144GB cho kết quả 20.736GB, chưa tính khác biệt trong cách tính dung lượng. Mô tả về tủ máy chủ cần nêu rõ cấu hình card và dung lượng bộ nhớ mà khối lượng công việc có thể sử dụng.
Iluvatar CoreX ước tính hệ thống có thể giảm khoảng 40% chi phí trên mỗi triệu token hiệu dụng so với các hệ thống quốc tế phổ biến. Token hiệu dụng là đầu ra được tính là công việc hữu ích. Với đơn vị vận hành bán dịch vụ AI, chỉ số này liên hệ chi phí phần cứng với lượng đầu ra sử dụng được tạo ra.
Mức giảm 40% đồng nghĩa chi phí còn 60 đơn vị cho khối lượng công việc vốn tốn 100 đơn vị trên hệ thống tham chiếu. Mức tiết kiệm thực tế sẽ phụ thuộc vào giá thiết bị, mức tiêu thụ điện, phần mềm, khối lượng công việc và mức độ hoạt động liên tục của GPU.
Công ty cũng đặt mục tiêu cho thế hệ tiếp theo của bộ kết nối ngang hàng: giảm thời gian truyền đơn lẻ trong miền kết nối từ 3 đến 5 microgiây xuống còn 1 microgiây. Giao tiếp nhanh hơn sẽ hữu ích khi các GPU khác nhau nắm giữ những phần khác nhau của mô hình và phải trao đổi dữ liệu liên tục.
Phân chia công việc AI giữa các chip khác nhau
Phương thức triển khai không đồng nhất của Iluvatar CoreX phân công các phần khác nhau của tác vụ suy luận cho những loại bộ xử lý khác nhau. Theo cơ chế tách biệt AFD, Tiangai 300 đảm nhiệm toàn bộ giai đoạn prefill và các phép tính attention trong quá trình decode. XPU của đối tác xử lý các mạng chuyên gia feed forward.
XPU là tên gọi chung cho một loại bộ tăng tốc tính toán khác. Ý tưởng cốt lõi là giao cho mỗi bộ xử lý phần việc phù hợp nhất, trong khi một bộ lập lịch chung điều phối toàn bộ tác vụ. Mạng feed forward thực hiện một phần lớn khác trong quá trình xử lý toán học bên trong mô hình ngôn ngữ.
Công ty báo cáo độ trễ suy luận trong giai đoạn decode giảm 60% khi dùng cơ chế lập lịch thống nhất. Đây là cấu hình hệ thống riêng, khác với tuyên bố lợi thế thông lượng 5% so với H200, và sử dụng một chỉ số hiệu năng khác.
Shan Tianyi, người đứng đầu mảng AI và điện toán tăng tốc của công ty, cho rằng các hệ thống điện toán AI trong tương lai sẽ phụ thuộc vào việc tổ chức hiệu quả các loại chip khác nhau, thay vì dựa vào một loại bộ xử lý cho mọi tác vụ. Màn trình diễn AFD thể hiện chiến lược này bằng cách bố trí cụ thể GPU và bộ tăng tốc của đối tác.
Tuyên bố về phần mềm tập trung vào thời gian triển khai
Iluvatar CoreX cũng giới thiệu một nền tảng phần mềm AI phục vụ AI, nhằm tự động hóa một số khâu triển khai và tối ưu hóa. Công ty cho biết thời gian thiết lập môi trường giảm từ một giờ xuống còn 10 phút, trong khi số thao tác thủ công giảm từ hàng chục xuống còn một.
Với một tác vụ tối ưu hóa mô hình lớn, công ty cho biết thời gian xử lý giảm từ bảy ngày xuống dưới hai giờ, trong khi hiệu năng đạt gần gấp đôi mức trước đó. Những ví dụ này liên quan đến công sức kỹ thuật cần thiết để vận hành mô hình hiệu quả trên phần cứng.
Công ty cũng tuyên bố tích hợp sâu với FlyDSL, một ngôn ngữ dùng để phát triển các quy trình tính toán GPU. Theo công ty, tốc độ biên dịch tăng hơn 90%. Công ty mô tả một quy trình trước đây cần 10 người làm trong một ngày nay có thể được một người hoàn thành trong vài giờ.
Hỗ trợ phần mềm rất quan trọng vì bộ xử lý cần nhiều hơn phần cứng có khả năng tính toán. Mô hình, thư viện toán học và công cụ triển khai phải hoạt động đồng bộ. Các màn trình diễn phần mềm cho thấy khách hàng có thể cần bỏ ra bao nhiêu công sức kỹ thuật trước khi biến GPU mới thành một dịch vụ hoạt động được.
TY1200 mở rộng hướng tiếp cận sang robot
Sự kiện tại Thượng Hải cũng giới thiệu Tongyang TY1200, một bộ xử lý riêng hướng đến máy tính AI và trí tuệ hiện thân, bao gồm robot có khả năng cảm nhận và hành động trong thế giới vật lý. Khả năng tính toán mật độ cao được công bố là 300 TOPS, tức 300 nghìn tỷ phép toán mỗi giây. Tính toán mật độ cao tính các phép toán mà không dựa vào việc bỏ qua những phép tính có giá trị bằng không.
Iluvatar CoreX tuyên bố TY1200 đạt hiệu năng bằng 1,2 lần Nvidia Thor T5000 trong các thử nghiệm với Qwen3.8-27B và Qwen3.6-35B-A3B. Với các mô hình Cosmos-R2-2B và Cosmos-R2-8B trong những tình huống AI vật lý, công ty báo cáo hiệu năng lần lượt bằng 158% và 180% so với mốc Thor T5000.
Công ty cũng cho biết TY1200 có thể chạy mô phỏng vật lý tăng tốc bằng GPU với MuJoCo-Warp. Nhờ đó, hệ thống phát triển robot có thể mô phỏng chuyển động, huấn luyện chính sách điều khiển và kiểm tra hành động ngay tại chỗ. Chính sách điều khiển là tập hợp chỉ dẫn đã học mà robot dùng để quyết định cách di chuyển.
Các ứng dụng được nêu gồm robot hỗ trợ người dân trong quá trình thăm khám y tế, thị giác công nghiệp và hướng dẫn khách tham quan. Sản phẩm kế nhiệm dự kiến, TY2000, có mục tiêu tính toán được công bố là 600T. Những sản phẩm này mở rộng chiến lược của công ty từ máy chủ AI quy mô lớn sang thiết bị hoạt động gần người dùng và máy móc.
Điểm chính
- Iluvatar CoreX trình diễn phần cứng Tiangai 300 tại Thượng Hải ngày 28 tháng 10 năm 2026.
- Công ty viện dẫn thử nghiệm của Tập đoàn Điện lực Thượng Hải, cho thấy thông lượng trên mỗi card tương đương 1,05 lần hiệu năng Nvidia H200.
- Màn trình diễn huấn luyện Qwen3-32B trên hệ thống tám GPU được cho là đạt thông lượng trên mỗi card bằng 1,33 lần H100 ở độ chính xác FP8.
- Phương pháp chi tiết phía sau điểm chuẩn nổi bật của bên thứ ba chưa được công bố.
- Tủ máy chủ IXL144 có 144 GPU và 18 CPU, với tuyên bố giảm 40% chi phí trên mỗi triệu token hiệu dụng.
- Một cấu hình triển khai riêng, phân chia công việc giữa GPU và XPU, được cho là giúp giảm 60% độ trễ decode.
- Sự kiện cũng đề cập đến tự động hóa phần mềm và các ứng dụng của TY1200 trong AI cục bộ và mô phỏng robot.