Nhà sản xuất điện thoại vừa thay đổi tốc độ suy luận AI
Vào một sáng thứ Hai khiến ngành công nghệ bất ngờ, Xiaomi đã làm điều mà ít người dự đoán. Công ty vốn nổi tiếng với smartphone giá phải chăng, xe scooter điện và máy lọc không khí gia đình thông báo đã phá vỡ một rào cản lớn về tốc độ trí tuệ nhân tạo. Chế độ phục vụ mới MiMo-V2.5-Pro-UltraSpeed tạo ra hơn 1.000 token mỗi giây trên mô hình một nghìn tỷ tham số, đạt đỉnh gần 1.200 token trong các buổi trình diễn trực tiếp. Đây không phải phiên bản rút gọn của mô hình. Đó là MiMo-V2.5-Pro hàng đầu, một hệ thống AI tiên tiến có năng lực cạnh tranh với Claude Opus trong các bài kiểm tra lập trình.
Nội dung
- Nhà sản xuất điện thoại vừa thay đổi tốc độ suy luận AI
- Tốc độ 1.000 token mỗi giây thực sự có ý nghĩa gì?
- Cách Xiaomi vượt mặt các ông lớn chip tùy chỉnh
- Ba kỹ thuật tạo nên UltraSpeed
- Vì sao tốc độ mở ra những ứng dụng hoàn toàn mới?
- Quyền truy cập, giá cả và phát hành mã nguồn mở
- Xiaomi âm thầm vươn lên thành thế lực AI
- Tóm tắt
Điều khiến thông báo này gây kinh ngạc không chỉ là tốc độ, mà còn là phần cứng tạo nên tốc độ đó. Xiaomi đạt được những con số này bằng một nút máy chủ tiêu chuẩn duy nhất với tám GPU phổ thông, loại thiết bị có thể thuê từ bất kỳ nhà cung cấp dịch vụ đám mây lớn nào. Không có chip tùy chỉnh. Không có chip chuyên dụng cỡ đĩa ăn. Chỉ có những cải tiến phần mềm chạy trên phần cứng mà nhà phát triển có thể thuê ngay tối nay.
Tham số là các trọng số số học bên trong, quyết định cách một mô hình AI xử lý thông tin. Một nghìn tỷ tham số đồng nghĩa mô hình có thể nhận diện những quy luật cực kỳ phức tạp trong văn bản và mã nguồn. Token là các mảnh văn bản mà mô hình đọc và viết, mỗi token tương đương khoảng ba phần tư từ. Tạo ra hơn 1.000 token mỗi giây có nghĩa bộ não khổng lồ này đang hoạt động ở tốc độ trước đây được cho là bất khả thi nếu không có phần cứng chuyên dụng.
Trong nhiều năm, cuộc đua tăng tốc suy luận AI do các startup chip được rót vốn lớn và phát triển thiết kế silicon tùy chỉnh dẫn dắt. Xiaomi vừa chứng minh rằng kỹ thuật sáng tạo trên thiết bị tiêu chuẩn có thể vượt xa tất cả. Thành tựu này đặt ra câu hỏi trực diện: liệu phần cứng chuyên dụng đắt đỏ có thực sự cần thiết, khi tối ưu hóa phần mềm thông minh có thể mang lại kết quả vượt trội trên hạ tầng phổ biến?
Tốc độ 1.000 token mỗi giây thực sự có ý nghĩa gì?
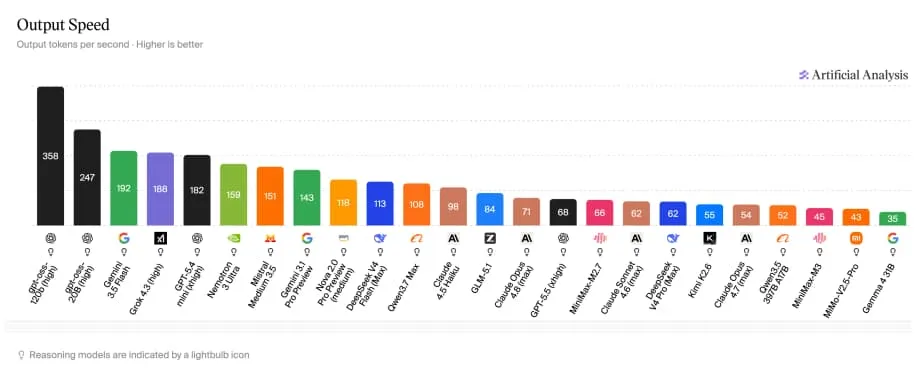
Để hiểu vì sao con số này đáng chú ý, hãy nhìn vào trải nghiệm của người dùng phổ thông hiện nay. Theo dữ liệu đo chuẩn của Artificial Analysis, GPT-5.5, mô hình vận hành phần lớn các cuộc trò chuyện trên ChatGPT, tạo ra khoảng 68 token mỗi giây. Claude Opus 4.6 đạt khoảng 71 token mỗi giây, trong khi mô hình Haiku nhẹ hơn của Anthropic đạt 98. Gemini Flash của Google nhanh hơn, ở mức 192 token mỗi giây. MiMo-V2.5-Pro-UltraSpeed đạt 1.000 token mỗi giây trên mô hình một nghìn tỷ tham số, nhanh gần 15 lần so với các chatbot mà hàng triệu người sử dụng hằng ngày.
Khoảng cách giữa 68 và 1.000 không đơn thuần là một cải thiện nhỏ. Nó thể hiện một cấp độ hiệu năng hoàn toàn khác. Với tốc độ hiện nay dành cho người dùng phổ thông, người dùng phải chờ vài giây để một đoạn văn xuất hiện. Ở tốc độ mới của Xiaomi, một trang phân tích đầy đủ có thể hiện ra gần như tức thì. Với các nhà phát triển chạy tác tử lập trình, khác biệt này biến trải nghiệm từ trao đổi qua lại có độ trễ thành thứ giống như cộng tác theo thời gian thực.
Token là đơn vị cơ bản của mô hình ngôn ngữ lớn. Khi bạn nhập câu lệnh, mô hình chia văn bản thành các token để xử lý. Khi trả lời, nó tạo từng token một, dự đoán mỗi token dựa trên toàn bộ nội dung trước đó. Mô hình tạo token càng nhanh thì càng phản hồi tốt và càng hoàn thành được nhiều tác vụ trong giới hạn thời gian nghiêm ngặt. Tốc độ cũng quyết định số yêu cầu mà một máy chủ có thể xử lý đồng thời, từ đó ảnh hưởng trực tiếp đến chi phí và khả năng mở rộng cho doanh nghiệp.
Mô hình Flash trước đó của MiMo-V2.5-Pro đã tạo phản hồi ở tốc độ 150 token mỗi giây, tương đương khoảng 110 từ mỗi giây, nhanh hơn tốc độ đọc hoặc nói của con người. UltraSpeed đẩy trần tốc độ này lên cao đáng kể, tạo ra tốc độ sinh văn bản vượt quá khả năng nhận thức của con người và cho phép triển khai các quy trình do máy vận hành vốn trước đây chưa thể thực hiện.
Cách Xiaomi vượt mặt các ông lớn chip tùy chỉnh
Nút thắt tốc độ suy luận AI đã thu hút hàng trăm triệu USD vốn đầu tư vào các công ty phát triển phần cứng chuyên dụng. Cerebras thiết kế một con chip cỡ tấm wafer, xấp xỉ kích thước đĩa ăn, tích hợp 44GB bộ nhớ trên chip để loại bỏ giới hạn băng thông. Thiết kế này đạt 969 token mỗi giây, một thành tích ấn tượng, nhưng trên Llama 3.1 405B của Meta, mô hình có 405 tỷ tham số. Quy mô đó chưa bằng một nửa MiMo-V2.5-Pro. Groq xây dựng kiến trúc bộ xử lý ngôn ngữ tùy chỉnh có thể đạt 300 đến 750 token mỗi giây tùy mô hình. Cả hai hệ thống đều không chạy trên phần cứng đám mây tiêu chuẩn mà nhà phát triển có thể thuê từ các nhà cung cấp như AWS.
Cách tiếp cận của Xiaomi đảo ngược hoàn toàn mô hình đó. Hợp tác với đối tác suy luận TileRT, công ty lập kỷ lục nhờ phương pháp mà họ gọi là đồng thiết kế hệ thống mô hình ở mức độ cao, tối ưu hóa phối hợp cả mô hình AI lẫn công cụ phần mềm phục vụ mô hình. Kết quả là một mô hình một nghìn tỷ tham số chạy nhanh hơn silicon chuyên dụng trên GPU phổ thông. Nếu các thử nghiệm độc lập xác nhận những chuẩn đo này, thành tựu cho thấy đổi mới phần mềm có thể khắc phục giới hạn phần cứng mà nhiều người cho rằng chỉ chip tùy chỉnh mới giải quyết được.
Diễn biến này mang ý nghĩa kinh tế thực sự. Silicon tùy chỉnh đòi hỏi vốn đầu tư khổng lồ, chu kỳ thiết kế kéo dài và quy trình sản xuất chuyên biệt. GPU phổ thông hưởng lợi từ lợi thế quy mô, khả năng cung ứng rộng rãi và những cải tiến liên tục của NVIDIA cùng các nhà sản xuất khác. Bằng cách giải quyết bài toán suy luận bằng phần mềm, Xiaomi có thể đã phổ cập tốc độ vốn trước đây chỉ dành cho các phòng thí nghiệm được đầu tư lớn và sở hữu phần cứng độc quyền.
Việc phát hành checkpoint FP4-DFlash trên Hugging Face bổ sung một khía cạnh khác cho nỗ lực phổ cập này. Các nhà nghiên cứu và nhà phát triển trên toàn thế giới giờ đây có thể kiểm tra, thử nghiệm và điều chỉnh mô hình nền mà không cần mua phần cứng độc quyền hay có giấy phép doanh nghiệp. Cộng đồng sẽ kiểm chứng liệu các kỹ thuật này có thể áp dụng rộng rãi cho những mô hình và trường hợp sử dụng khác hay không.
Ba kỹ thuật tạo nên UltraSpeed
Bước đột phá dựa trên ba kỹ thuật phối hợp với nhau. Không kỹ thuật nào tự mình lập được kỷ lục tốc độ, nhưng khi kết hợp, chúng đẩy hiệu năng vượt ngưỡng 1.000 token.
Kỹ thuật thứ nhất là lượng tử hóa FP4. Hầu hết mô hình lớn chạy ở độ chính xác số 16 bit hoặc 8 bit, nghĩa là mỗi tham số cần hai byte hoặc một byte bộ nhớ. Xiaomi nén các lớp chuyên gia, chiếm phần lớn trong một nghìn tỷ tham số, xuống độ chính xác 4 bit. Cách này giảm dung lượng bộ nhớ và áp lực băng thông, giúp dữ liệu di chuyển nhanh hơn trong hệ thống. Rủi ro của lượng tử hóa là suy giảm chất lượng, vì độ chính xác thấp hơn có thể làm giảm năng lực suy luận của mô hình. Cách Xiaomi xử lý vấn đề này rất có chọn lọc: chỉ các lớp chuyên gia được nén, còn phần còn lại của mô hình giữ nguyên độ chính xác đầy đủ. Công ty mô tả mức suy giảm chất lượng sau đó là gần như bằng không.
Kỹ thuật thứ hai là giải mã suy đoán DFlash. Giải mã suy đoán truyền thống dùng một mô hình nháp nhỏ hơn để nhanh chóng đoán vài token tiếp theo, sau đó mô hình lớn xác minh các dự đoán đó song song. DFlash loại bỏ hoàn toàn bước soạn nháp tuần tự. Thay vào đó, nó điền cả một khối vị trí bị che trong một lượt truyền tiến duy nhất. Trong các tác vụ lập trình, mô hình lớn chấp nhận trung bình 6,3 trong số 8 token được đề xuất ở mỗi vòng xác minh. Điều đó có nghĩa sáu token được tạo ra trong một bước thay vì một, giúp tăng tốc độ sinh văn bản đáng kể.
Thành phần thứ ba là TileRT, công cụ suy luận giữ toàn bộ quy trình tính toán thường trú liên tục bên trong GPU. Các hệ thống phục vụ tiêu chuẩn thường khởi chạy từng toán tử riêng lẻ, tạo ra những khoảng ngắt nhỏ trong quá trình thực thi. TileRT loại bỏ độ trễ khởi chạy theo từng toán tử và giữ cho dữ liệu luân chuyển liên tục. Khi kết hợp với trọng số mô hình đã nén và chiến lược giải mã tiên tiến, công cụ này duy trì mức thông lượng trước đây không thể đạt được trên phần cứng tiêu chuẩn.
Xiaomi gọi sự kết hợp này là đồng thiết kế hệ thống mô hình ở mức độ cao, và tên gọi đó phù hợp. Mỗi lớp tối ưu hóa củng cố các lớp còn lại, tạo nên kết quả vượt trội so với khả năng của từng kỹ thuật riêng lẻ.
Vì sao tốc độ mở ra những ứng dụng hoàn toàn mới?
Chuẩn đo hiệu năng thô chẳng có ý nghĩa nếu không giúp tạo ra điều gì mới. Với tốc độ 1.000 token mỗi giây, MiMo-V2.5-Pro-UltraSpeed mở ra những khả năng mà các hệ thống chậm hơn vẫn chưa thể thực hiện.
Hãy xem cách các nhà phát triển hiện dùng mô hình ngôn ngữ lớn cho những tác vụ phức tạp. Khi gặp một bài toán lập trình khó, người dùng thường chờ một câu trả lời và hy vọng nó chính xác. Với UltraSpeed, cùng người dùng đó có thể chạy song song hàng chục hướng suy luận trong cùng một khoảng thời gian thực, đồng thời tự động xác minh và tự sửa ở chế độ nền. Mô hình có thể đồng thời khám phá nhiều giải pháp thay vì chỉ chọn một chuỗi suy nghĩ duy nhất. Khả năng này biến đổi căn bản AI, từ một trợ lý xử lý tuần tự thành một công cụ giải quyết vấn đề song song.
Những ngành có yêu cầu nghiêm ngặt về độ trễ sẽ hưởng lợi ngay lập tức. Hệ thống phát hiện gian lận phải đánh giá giao dịch trong vài mili giây. Việc tạo tín hiệu giao dịch theo thời gian thực không thể chấp nhận độ trễ vài giây. Các vòng lặp tác tử tự động, trong đó hệ thống AI quan sát, quyết định và hành động theo chu kỳ nhanh, cần tốc độ mà chatbot cho người dùng phổ thông không thể đáp ứng. Ở mức 68 token mỗi giây, các ứng dụng này gặp phải những nút thắt gây cản trở. Ở mức 1.000 token mỗi giây, chúng có thể vận hành trên hạ tầng đám mây tiêu chuẩn.
Ngay cả trong quy trình lập trình hằng ngày, tốc độ cũng làm thay đổi tâm lý người dùng. Trước đây, nhà phát triển nhìn chằm chằm vào màn hình trong lúc chờ suy luận hoàn tất. Khi đầu ra đạt và vượt 1.000 token mỗi giây, độ trễ gần như biến mất. Tương tác chuyển từ gửi yêu cầu rồi chờ đợi sang cộng tác thực sự theo thời gian thực với một đối tác AI. Các ứng dụng y tế cần phân tích nhanh dữ liệu bệnh nhân và nền tảng đầu tư xử lý luồng dữ liệu thị trường trực tiếp đều có thể hưởng lợi thiết thực ngay từ mức độ phản hồi này.
Quyền truy cập, giá cả và phát hành mã nguồn mở
Xiaomi không giữ công nghệ này sau cánh cửa đóng kín. Công ty đã triển khai thử nghiệm API giới hạn từ ngày 9 đến ngày 23 tháng 6 năm 2026. Người dùng phải đăng ký để được cấp quyền truy cập, nhưng không đảm bảo sẽ được chấp thuận. Doanh nghiệp và nhà phát triển chuyên nghiệp có nhu cầu kinh doanh cụ thể được ưu tiên. Vì nguồn lực suy luận tốc độ cao có hạn, mỗi tài khoản có thể vào hàng chờ tối đa mười lần mỗi ngày, mỗi phiên kéo dài không quá ba mươi phút. Các phiên không hoạt động quá năm phút sẽ tự động được giải phóng.
Cơ cấu giá phản ánh tính cao cấp của tốc độ này. UltraSpeed có giá gấp ba lần mức tiêu chuẩn của MiMo-V2.5-Pro, nhưng cho tốc độ sinh văn bản cao hơn khoảng mười lần. Để so sánh, MiMo-V2.5-Pro tiêu chuẩn vốn đã rẻ hơn Claude Opus đáng kể, với mức phí khoảng 0,43 USD cho mỗi triệu token đầu vào và 0,87 USD cho mỗi triệu token đầu ra, so với 5 USD đầu vào và 25 USD đầu ra cho mỗi triệu token của Opus. Ngay cả khi giá tăng gấp ba, phiên bản tăng tốc của Xiaomi vẫn rẻ hơn nhiều mô hình tiên tiến cạnh tranh.
Với các nhà phát triển muốn trực tiếp thử nghiệm công nghệ, Xiaomi đã phát hành checkpoint MiMo-V2.5-Pro-FP4-DFlash nền tảng theo giấy phép mã nguồn mở trên Hugging Face. TileRT cũng phát hành một số mô-đun trên GitHub. Động thái này mời gọi cộng đồng nghiên cứu toàn cầu xác minh các chuẩn đo, thử nghiệm kiến trúc và có thể điều chỉnh kỹ thuật cho những mô hình khác. Hiện chưa có nhiều kết quả xác minh độc lập từ bên thứ ba được công bố, vì vậy hoạt động thử nghiệm cộng đồng thông qua các bản phát hành mở này sẽ là phép kiểm chứng thực sự trong những tuần tới.
Xiaomi âm thầm vươn lên thành thế lực AI
Với phần lớn người tiêu dùng, Xiaomi vẫn là thương hiệu bán đồ điện tử giá phải chăng. Công ty đã bán hàng triệu smartphone, xe scooter điện và máy lọc không khí tại các thị trường toàn cầu. Hình ảnh tiêu dùng đó đã che khuất một bộ phận trí tuệ nhân tạo ngày càng phát triển, vốn bị phần lớn ngành công nghiệp bỏ qua cho đến nay.
MiMo-V2.5-Pro vốn đã ngang tầm Claude Opus trong hầu hết bài kiểm tra lập trình khi ra mắt vào tháng 4. UltraSpeed không giới thiệu một mô hình mới hay bị cắt giảm năng lực. Nó tăng tốc chính mô hình tiên tiến đang cạnh tranh ở nhóm dẫn đầu. Thương hiệu điện thoại này về cơ bản đã xây dựng năng lực AI ngang tầm các phòng thí nghiệm chuyên biệt, đồng thời duy trì mức giá thấp hơn họ cả một bậc độ lớn.
Nếu các tuyên bố về tốc độ vượt qua được sự thẩm định độc lập, Xiaomi sẽ đạt được thành tựu phi thường mà không cần hàng trăm triệu USD đầu tư vào silicon tùy chỉnh như Cerebras và Groq. Công ty sẽ chứng minh tối ưu hóa phần mềm trên phần cứng phổ thông có thể mang lại hiệu năng dẫn đầu phân khúc. Kết quả đó sẽ làm thay đổi các giả định về nguồn gốc năng lực AI và những bên có thể cạnh tranh ở tuyến đầu. Một tập đoàn điện tử tiêu dùng từ Bắc Kinh vừa gia nhập nhóm dẫn đầu về đổi mới hạ tầng AI, với GPU tiêu chuẩn thay vì silicon tùy chỉnh.
Tóm tắt
- MiMo-V2.5-Pro-UltraSpeed của Xiaomi tạo ra hơn 1.000 token mỗi giây trên mô hình một nghìn tỷ tham số, chỉ sử dụng tám GPU phổ thông tiêu chuẩn, không cần silicon tùy chỉnh.
- Tốc độ này nhanh hơn GPT-5.5 và Claude Opus khoảng 15 lần, nhờ lượng tử hóa FP4, giải mã suy đoán DFlash và công cụ suy luận TileRT.
- Chương trình thử nghiệm API giới hạn diễn ra từ ngày 9 đến ngày 23 tháng 6 năm 2026, có giá gấp ba lần mức MiMo tiêu chuẩn để đổi lấy tốc độ sinh văn bản cao hơn khoảng mười lần; doanh nghiệp và nhà phát triển chuyên nghiệp được ưu tiên.
- Xiaomi đã phát hành checkpoint FP4-DFlash theo giấy phép mã nguồn mở trên Hugging Face, cho phép cộng đồng kiểm chứng và điều chỉnh các kỹ thuật này.
- Nếu được xác minh độc lập, bước đột phá cho thấy tối ưu hóa phần mềm trên phần cứng đám mây tiêu chuẩn có thể vượt trội các giải pháp chip tùy chỉnh đắt đỏ của những công ty phần cứng AI chuyên biệt.